ให้ AI โจมตีแผนตัวเองก่อนลงมือ: บันทึก 293 รอบของ adversarial gate ที่ใช้สร้าง Terminal
AI เห็นด้วยกับเราเก่งเกินไป ผมเลยให้โมเดลอีกตัวรับบท 'ฝ่ายค้าน' ตรวจทุกแผนสำคัญก่อนลงมือ บันทึกจริง 293 รอบ: ใน 200 รอบที่มีคำตัดสิน 191 รอบจบด้วยการแก้แผน พร้อมตัวอย่างจริงวันนี้ที่คำวิจารณ์เดียวเปลี่ยนวิธีตั้ง URL ของทั้งเว็บ
โดย วรัญชัย ยิ่งคำนึง (Boom) · เผยแพร่ครั้งแรก · ตรวจทานล่าสุด
ปัญหาที่ใครใช้ AI วางแผนนานพอจะเจอ: มันเห็นด้วยกับเราเก่งเกินไป เราเสนอแผน มันบอกว่าดี เราถามว่ามีจุดอ่อนไหม มันหาให้สองสามข้อแบบเบาๆ แล้วสรุปว่าแผนโดยรวมแข็งแรง — ทั้งที่จุดพังจริงอยู่ในสมมติฐานที่ไม่มีใครตั้งคำถาม
ตอนสร้าง Boom Leverage Terminal ผมจึงวางกฎว่า แผนที่มีการตัดสินใจสำคัญต้องผ่านฝ่ายค้านก่อน และฝ่ายค้านต้องไม่ใช่โมเดลตัวเดียวกับที่เขียนแผน
ทำไมให้ AI ตัวเดิมตรวจงานตัวเองถึงไม่พอ?
เพราะมันมีจุดบอดเดียวกับตอนเขียน สมมติฐานที่ทำให้มันเขียนแผนแบบนั้น คือสมมติฐานเดียวกับที่มันใช้ตรวจ คนทำ model validation คุ้นกับหลักนี้ดี — คนสร้างโมเดลไม่ควรเป็นคน validate โมเดลตัวเอง แบงก์ถึงต้องแยกทีม validation ออกจากทีม development
adversarial gate คือหลักเดียวกันในขนาดเล็ก: แผนเขียนโดยโมเดลหนึ่ง ถูกโจมตีโดยโมเดลอีกตัวที่ถูกสั่งให้ หาทางทำให้แผนพัง ไม่ใช่ให้ความเห็นทั่วไป
ขั้นตอนจริงเป็นยังไง?
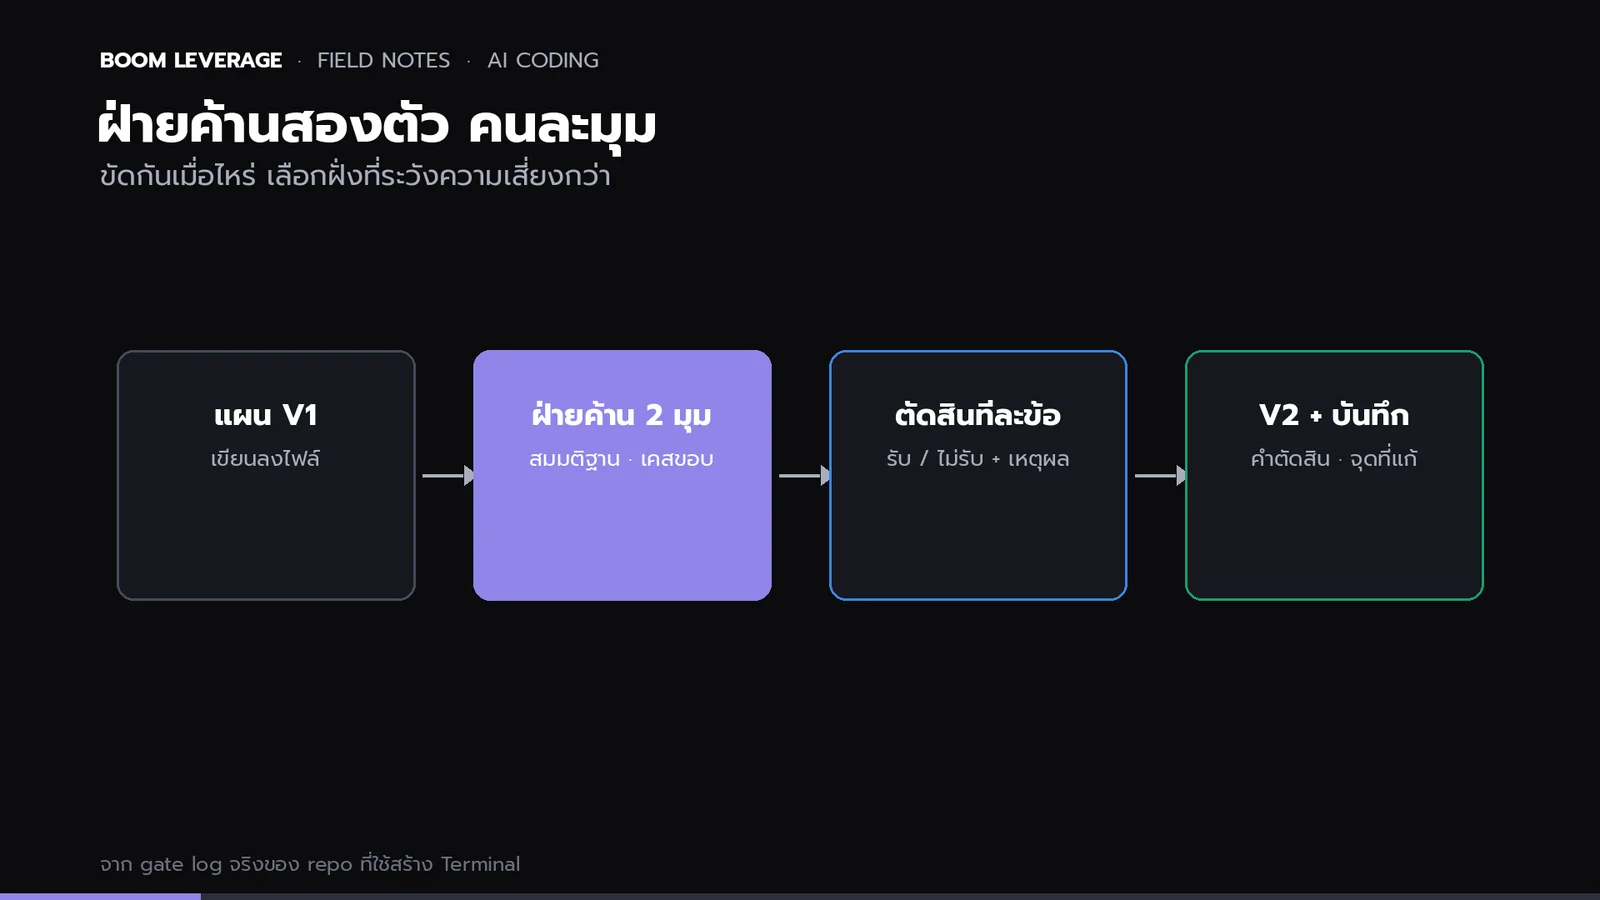
- เขียนแผน V1 ลงไฟล์ — ไม่ใช่ในหัว ไม่ใช่ในแชต
- ส่งให้ฝ่ายค้าน 2 ครั้ง คนละมุม: มุม "สมมติฐาน" (อะไรที่แผนเชื่อโดยไม่มีหลักฐาน) และมุม "เคสขอบ" (สถานการณ์ไหนที่ทำให้พัง โอกาสเกิดเท่าไหร่)
- คนเขียนแผนอ่านทั้งสองฝั่ง แล้วตัดสินทีละข้อ: รับ / ไม่รับ พร้อมเหตุผล ถ้าสองฝั่งขัดกัน เลือกฝั่งที่ระวังความเสี่ยงมากกว่า
- แก้เป็น V2 และบันทึก คำตัดสิน จำนวนจุดที่แก้ และ backend ที่ใช้ ลง log
แผนแบบไหนต้องผ่านด่าน: แผนที่มีการตัดสินใจให้ Boom เคาะ · การเปลี่ยน infra · สรุปผลที่จะกลายเป็นกฎ ส่วนงานประจำ (เขียนบันทึก ดึงข้อมูล) ไม่ต้อง
ผลจริงจาก 293 รอบเป็นยังไง?

| ตัวชี้วัด | ค่า |
|---|---|
| จำนวนรอบทั้งหมด | 293 (26 พ.ค. – 27 ก.ย. 2026) |
| รอบที่บันทึกคำตัดสิน | 200 |
| จบด้วยการแก้แผน (REVISE และแบบที่แก้แล้วผ่าน) | 191 |
| ผ่านเลย (PASS) | 7 |
| อื่นๆ (error / รูปแบบไม่มาตรฐาน) | 2 |
| จุดที่แก้รวม (จาก 194 รอบที่บันทึกจำนวน) | 540 |
ตัวเลขนี้บอกสองอย่าง อย่างแรก แผนแทบทุกแผนมีจุดที่ควรแก้ ถ้าไม่มีด่านนี้ จุดเหล่านั้นจะไปโผล่ตอนลงมือแล้ว ซึ่งแพงกว่า อย่างที่สอง ต้องยอมรับตรงๆ ว่า 93 รอบไม่ได้บันทึกคำตัดสิน — log ช่วงแรกไม่มีรูปแบบบังคับ ข้อสรุปคือ log ที่ไม่มี schema ทำให้วัดผลย้อนหลังได้ไม่ครบ

การใช้งานพุ่งช่วง ส.ค.–ก.ย. (124 และ 115 รอบ) ตรงกับช่วงที่ Terminal มีลูกค้าจริงและการตัดสินใจแต่ละครั้งมีต้นทุนสูงขึ้น ฝ่ายค้านส่วนใหญ่วิ่งบน gemma-4-31b (328 ครั้ง) และสลับไปใช้ backend สำรองเมื่อ API หลักล่ม
ตัวอย่างจริง: คำวิจารณ์เดียวเปลี่ยนอะไรได้บ้าง?
วันที่เขียนบทความนี้ ผมวางแผนย้ายบทความเก่าจาก boomleverage.com มาไว้ที่ Field Notes แผน V1 บอกว่า "เปลี่ยน redirect ของ URL เก่าให้ชี้มาที่นี่" ฝ่ายค้านมุมเคสขอบตอบกลับมาแบบนี้:

308 is a "Permanent Redirect" and is cached by browsers; users will be sent to a 404 on the lab site even if the server-side redirect is updated, breaking the SEO bridge
ข้อนี้ถูก และผมไม่ได้คิดถึงมันใน V1 ผลที่เกิดขึ้นจริงในเว็บนี้: ทุกบทความใช้ URL ชื่อเดิมจากเว็บหลัก (เช่น /notes/why-i-chose-claude-code-harness) และมีกฎว่า slug ที่เผยแพร่แล้ว ห้ามเปลี่ยนชื่อ ถ้าจำเป็นต้องย้ายให้ทำ redirect ฝั่ง lab แทน — ทั้งหมดตัดสินก่อนเขียนโค้ดบรรทัดแรก
อีกข้อจากฝ่ายค้านมุมสมมติฐานในรอบเดียวกัน: แผนเชื่อว่าคนอ่านบทความเรื่อง AI coding จะสนใจ workshop โดยไม่มีหลักฐาน ผลคือผมเพิ่มการวัดคลิก CTA แยกตามบทความ และตั้งเกณฑ์ทบทวนหลัง 4 สัปดาห์ — สมมติฐานที่พิสูจน์ไม่ได้วันนี้ อย่างน้อยต้องวัดได้
จะไม่ให้การวิจารณ์กลายเป็นพิธีกรรมได้ยังไง?
ความเสี่ยงของด่านที่แทบทุกรอบจบด้วย "แก้" คือมันอาจกลายเป็นพิธี — ฝ่ายค้านหาอะไรมาติสักข้อเสมอ และคนเขียนแผนแก้แบบผิวๆ ให้ผ่าน วิธีที่ผมใช้กันเรื่องนี้:
- ต้องตัดสินทีละข้อ รับหรือไม่รับ พร้อมเหตุผล ไม่มี "รับทราบ" ลอยๆ
- คำวิจารณ์ต้องมีกลไก — "อาจมีปัญหา" ไม่นับ ต้องบอกว่าเกิดจากอะไร พังยังไง โอกาสเท่าไหร่
- ข้ามได้ตามกฎที่เขียนไว้ แผนที่แก้เอกสารจุดเดียว ลบกฎที่มีอยู่ และไม่แตะเรื่องความปลอดภัย ข้ามด่านได้ ด่านที่ใช้กับทุกอย่างจะถูกทำแบบลวกๆ
- บันทึกทุกครั้ง เพื่อให้วัดได้ว่าด่านยังมีประโยชน์ไหม (และแก้ log ให้มี schema — ตามที่ตัวเลข 93 รอบข้างบนสอน)
ด่านนี้คู่กับด่านที่เครื่องบังคับอย่าง hook: hook กันสิ่งที่ ผิดแน่นอน ส่วน adversarial gate จับสิ่งที่ ต้องใช้วิจารณญาณ อ่านเรื่อง hook ได้ที่ ด่านอนุมัติ + hook ส่วนแผนที่ผ่านด่านแล้วแต่ยังไม่แน่ใจว่าได้ผลจริง ให้ทดลองก่อนแก้ระบบจริง ตามที่เขียนไว้ใน ทดลองก่อนแก้
สรุป
AI ที่เห็นด้วยกับเราเสมอคือความเสี่ยงที่มองไม่เห็น การให้โมเดลอีกตัวรับบทฝ่ายค้านคนละมุม ทำให้จุดพังโผล่ขึ้นมาตอนที่ยังแก้ได้ถูกที่สุด คือตอนที่แผนยังเป็นแค่ไฟล์ข้อความ
คำถามที่พบบ่อย
- adversarial gate หรือการให้ AI โจมตีแผนตัวเองคืออะไร
- คือการให้โมเดลคนละตัวกับที่เขียนแผนรับบทฝ่ายค้าน โดยถูกสั่งให้หาทางทำให้แผนพัง ไม่ใช่ให้ความเห็นทั่วไป เป็นหลักเดียวกับ model validation ในแบงก์ที่คนสร้างโมเดลไม่ควรเป็นคน validate โมเดลตัวเอง
- ทำไมให้ AI ตัวเดิมตรวจแผนของตัวเองถึงไม่พอ
- เพราะมันมีจุดบอดเดียวกับตอนเขียน สมมติฐานที่ทำให้เขียนแผนแบบนั้นคือสมมติฐานเดียวกับที่ใช้ตรวจ AI ที่วางแผนจึงมักเห็นด้วยกับแผนตัวเองและหาจุดอ่อนให้แบบเบาๆ ทั้งที่จุดพังจริงอยู่ในสมมติฐานที่ไม่มีใครตั้งคำถาม
- ขั้นตอน adversarial review ของแผนใน Claude Code ทำอย่างไร
- เขียนแผน V1 ลงไฟล์ ส่งให้ฝ่ายค้าน 2 ครั้งคนละมุม คือมุมสมมติฐานที่ไม่มีหลักฐานและมุมเคสขอบที่ทำให้พัง จากนั้นคนเขียนแผนตัดสินทีละข้อว่ารับหรือไม่รับพร้อมเหตุผล ถ้าสองฝั่งขัดกันให้เลือกฝั่งที่ระวังความเสี่ยงมากกว่า แล้วแก้เป็น V2 และบันทึกลง log
- ผลจริงของ adversarial gate ที่ใช้สร้าง Terminal เป็นอย่างไร
- ช่วง 26 พ.ค. ถึง 27 ก.ย. 2026 มี 293 รอบ ใน 200 รอบที่บันทึกคำตัดสิน 191 รอบจบด้วยการแก้แผนและ 7 รอบผ่านเลย รวมจุดที่แก้ 540 จุด ส่วนอีก 93 รอบไม่ได้บันทึกคำตัดสินเพราะ log ช่วงแรกไม่มี schema
- จะป้องกันไม่ให้การวิจารณ์แผนกลายเป็นพิธีกรรมได้อย่างไร
- ต้องตัดสินทีละข้อพร้อมเหตุผล คำวิจารณ์ต้องมีกลไกว่าเกิดจากอะไร พังยังไง โอกาสเท่าไหร่ ให้ข้ามด่านได้ตามกฎที่เขียนไว้ เช่น แผนที่แก้เอกสารจุดเดียว ลบกฎที่มีอยู่ และไม่แตะเรื่องความปลอดภัย และบันทึกทุกครั้งเพื่อวัดว่าด่านยังมีประโยชน์