Harness คืออะไร — ทำไมความเก่งของ AI agent ส่วนใหญ่อยู่นอกตัวโมเดล (อธิบายผ่านการสร้าง Terminal)
Harness คือทุกอย่างที่หุ้มโมเดลให้กลายเป็น agent ที่ทำงานจริงได้: เครื่องมือ บริบท สิทธิ์ hook และวงจรทำงาน หลักฐานปี 2026 ชี้ว่าโมเดลเดิมแต่เปลี่ยน harness คะแนนขยับ 13.7 จุด และ loop engineering ที่มาแรงเป็นแค่ 1 ใน 5 ชิ้น นี่คือแผนที่ทั้งก้อน พร้อมตัวอย่างจากระบบที่สร้าง Boom Leverage Terminal
โดย วรัญชัย ยิ่งคำนึง (Boom) · เผยแพร่ครั้งแรก · ตรวจทานล่าสุด
เวลามีคนถามว่า "ใช้ AI ตัวไหนดี" ผมมักตอบว่าคำถามนั้นยังไม่ครบ เพราะความเก่งที่เห็นเวลา agent ทำงานจริง ส่วนใหญ่ไม่ได้มาจากโมเดลล้วนๆ แต่มาจาก harness — ชั้นซอฟต์แวร์ที่หุ้มโมเดลไว้แล้วทำให้มันลงมือทำงานได้เป็นเรื่องเป็นราว
บทความนี้จะแยก harness ออกเป็นชิ้นให้เห็นภาพ โดยใช้ของจริงจากระบบที่ผมใช้สร้าง Boom Leverage Terminal (เครื่องมือค้นเอกสาร 56-1 และ MD&A ทั้งตลาดหุ้นไทยพร้อมเลขหน้าต้นฉบับ) เป็นตัวอย่าง ถ้าอยากรู้ว่าหลักคิดนี้ทำให้ผมเลือกเครื่องมือยังไงในทางปฏิบัติ อ่านคู่กับ ทำไมผมสร้าง Terminal ด้วย Claude Code — ไม่ใช่เพราะโมเดลเก่งสุด แต่เพราะ harness
Harness คืออะไร อธิบายให้สั้นที่สุด?
โมเดลคือสมอง harness คือร่างกายกับกฎที่ทำให้สมองลงมือทำงานในโลกจริงได้ สมองเปล่าๆ ทำได้แค่คิดแล้วพ่นข้อความออกมา มันเปิดไฟล์เองไม่ได้ รันคำสั่งเองไม่ได้ และจำสิ่งที่เพิ่งทำไม่ได้ถ้าไม่มีใครป้อนกลับ
Addy Osmani วิศวกรที่ Google สรุปไว้ใน Agent Harness Engineering (19 เม.ย. 2026) ว่า "A coding agent is the model plus everything you build around it." และตั้งสมการที่จำง่ายว่า "Agent = Model + Harness. If you're not the model, you're the harness." ฝั่งผู้สร้างโมเดลก็ใช้คำนี้ตรงๆ — Anthropic เขียนใน Effective harnesses for long-running agents (26 พ.ย. 2025) ว่า Claude Agent SDK คือ "a powerful, general-purpose agent harness"
เบื้องหลัง 1 คำสั่ง harness ทำอะไรบ้าง?
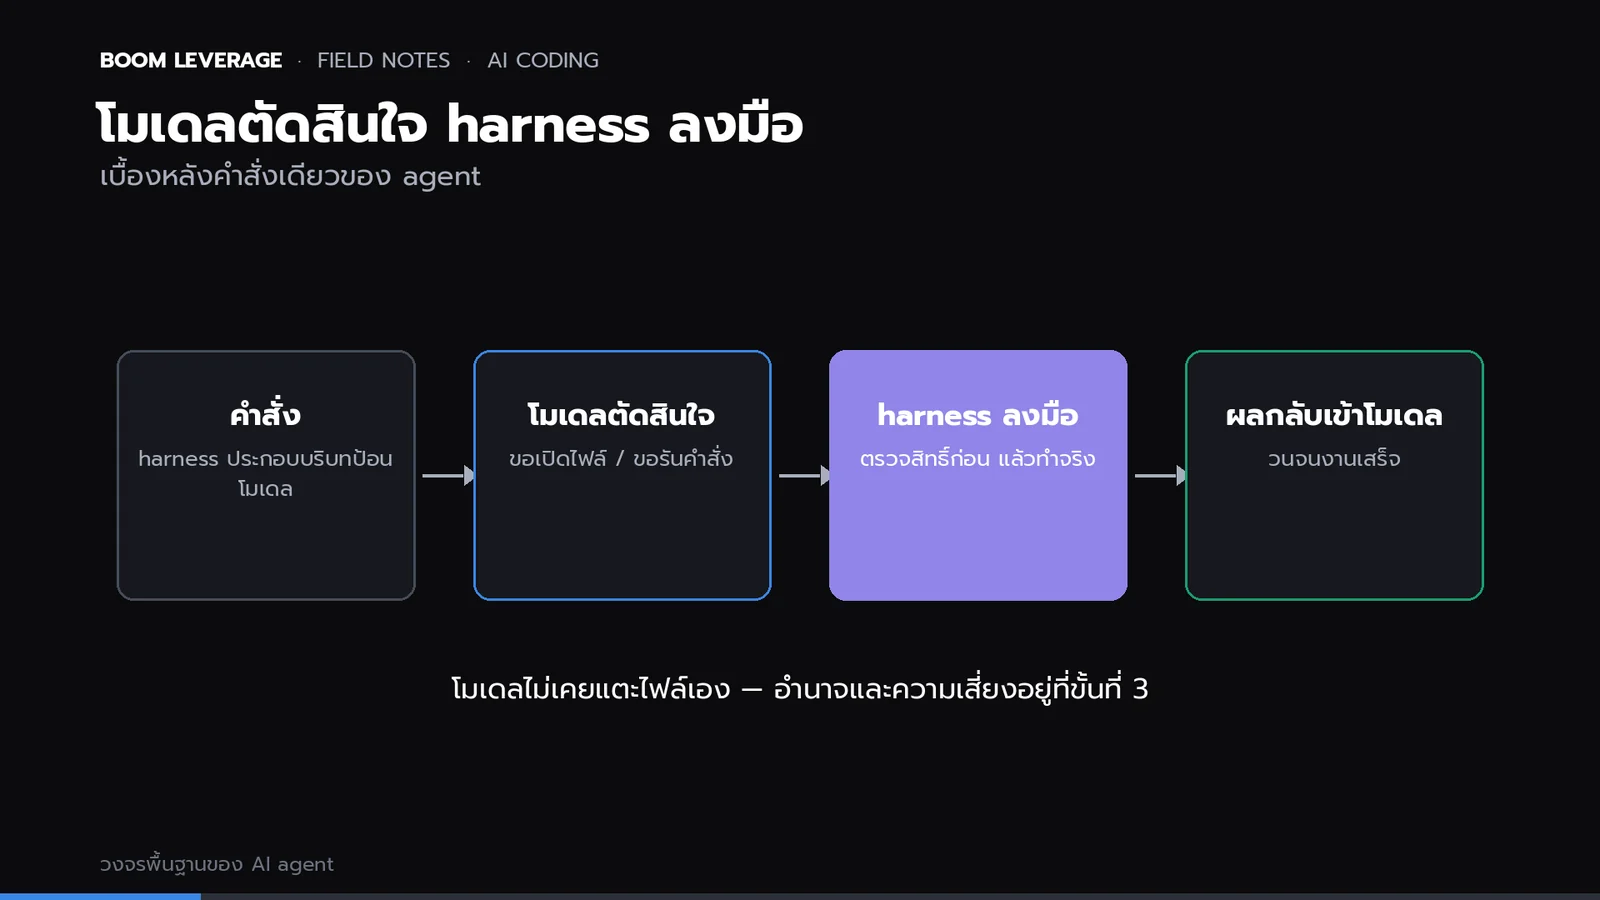
สมมติผมสั่งว่า "แก้ตัวดึงเอกสาร 56-1 ให้รองรับไฟล์สแกน แล้วรันเทสต์ให้ผ่าน" สิ่งที่เกิดขึ้นคือ:
- คำสั่ง — harness รับคำสั่ง แล้วประกอบบริบทป้อนโมเดล (กฎของโปรเจกต์ ไฟล์ที่เกี่ยว ผลรอบก่อน)
- โมเดลตัดสินใจ — ตอบกลับมาว่า "ขอเปิดไฟล์นี้" หรือ "ขอรันคำสั่งนี้"
- harness ลงมือ — ตรวจสิทธิ์ก่อนว่าคำสั่งนี้ทำได้ไหม แล้วค่อยเปิดไฟล์หรือรันจริง
- ผลกลับเข้าโมเดล — วนแบบนี้จนโมเดลเลิกขอเรียกเครื่องมือ
ตัวโมเดลไม่เคยแตะไฟล์เองเลยสักครั้ง ขั้นที่ 3 ทั้งหมดเป็นโค้ดของ harness ประโยคที่ผมชอบใช้คือ โมเดลตั้งเพดาน harness กำหนดว่าเราเข้าใกล้เพดานนั้นได้แค่ไหน
มีหลักฐานไหมว่า harness สำคัญพอๆ กับโมเดล?
มี และเป็นตัวเลขที่วัดได้
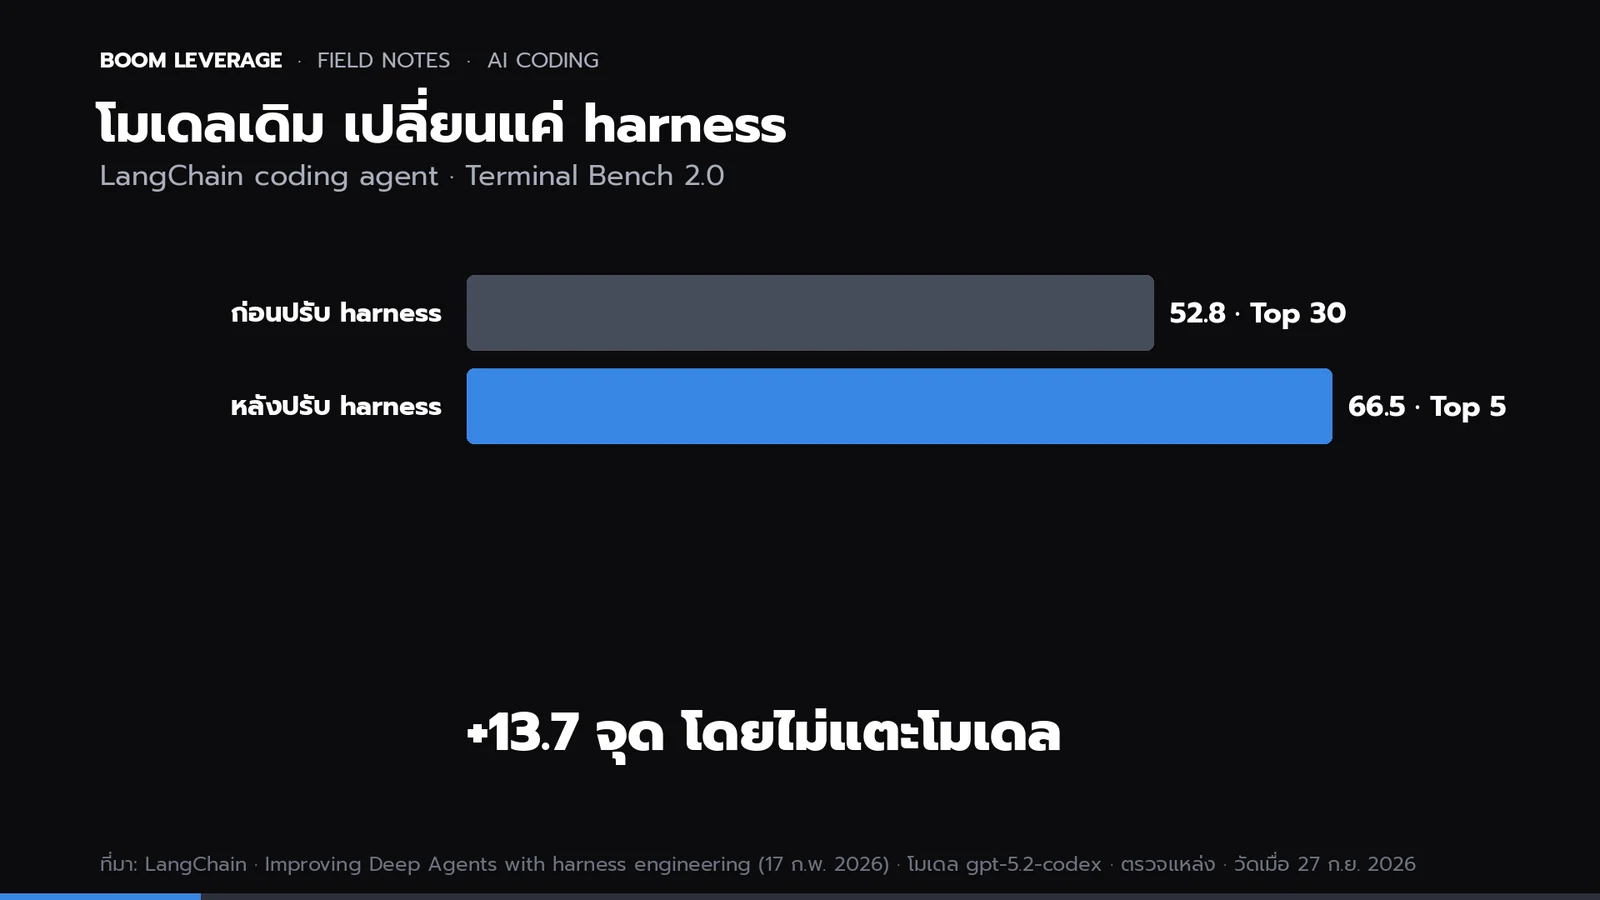
เคส LangChain — ทีมเขียนใน Improving Deep Agents with harness engineering (17 ก.พ. 2026) ว่า "we only tweaked the harness and kept the model fixed, gpt-5.2-codex" ผลคือคะแนนบน Terminal Bench 2.0 ขยับ 13.7 จุด จาก 52.8 เป็น 66.5 หรือ "from Top 30 to Top 5" สิ่งที่ปรับมีแค่ 3 อย่าง: System Prompt, Tools และ Middleware — เปลือกรอบโมเดลล้วนๆ
| ก่อนปรับ harness | หลังปรับ harness | |
|---|---|---|
| โมเดล | gpt-5.2-codex | gpt-5.2-codex (ตัวเดิม) |
| คะแนน Terminal Bench 2.0 | 52.8 | 66.5 |
| อันดับ | Top 30 | Top 5 |
งานวิจัย Harness-Bench — Harness-Bench (arXiv, 27 พ.ค. 2026) วัดเรื่องนี้อย่างเป็นระบบด้วยงาน 106 ชิ้นในสภาพแวดล้อมปิด รวม 5,194 เส้นทางการทำงาน harness ที่คะแนนรวมสูงสุด (NanoBot 76.2) กับต่ำสุด (OpenClaw 52.4) ห่างกัน 23.8 จุด บนงานชุดเดียวกัน ข้อสรุปของเขาคือประโยคที่คนทำ model risk ควรจำ:

"agent capability should be reported at the model–harness configuration level rather than attributed to the base model alone."
แปลเป็นภาษาคนทำ validation: เราไม่เคย validate สมการลอยๆ เราตรวจทั้งระบบที่มันถูกใช้งานจริง AI agent ก็เหมือนกัน หน่วยที่ต้องตรวจคือ โมเดล + harness ทุกครั้งที่เปลี่ยน prompt เครื่องมือ หรือ hook เท่ากับเปลี่ยนระบบที่ต้องตรวจใหม่
Harness ประกอบด้วยอะไร — 5 ชิ้นที่ต้องรู้จัก
| ชิ้น | ทำอะไร | ตัวอย่างในระบบที่สร้าง Terminal |
|---|---|---|
| เครื่องมือ (Tools) | สิ่งที่ยื่นให้โมเดลเรียกใช้ — อ่าน/เขียนไฟล์ รันคำสั่ง ต่อข้อมูล | สคริปต์ที่พิสูจน์แล้วว่าทำซ้ำได้ ถูกแปลงเป็นคำสั่งเดียว |
| บริบท (Context) | ตัดสินใจว่าแต่ละก้าวจะป้อนอะไรเข้าสมอง | CLAUDE.md + wiki ที่โหลดทุก session |
| สิทธิ์ (Permission) | คำสั่งไหนทำเองได้ คำสั่งไหนต้องรอคนเคาะ | ห้าม push ขึ้น production เองจนกว่าจะมีคนอนุมัติ |
| Hook / Middleware | จุดแทรกกลางทาง บังคับกติกาด้วยเครื่อง | ดักคำสั่งอ่านไฟล์ลับ · เปลี่ยนการลบถาวรเป็นย้ายเข้าถังพัก |
| วงจร (Loop) | วน คิด → เรียกเครื่องมือ → เห็นผล → คิดต่อ จนเสร็จ | agent ทำงานเป็นเป้าหมาย ไม่ใช่ตอบทีละคำถาม |
พอแยกแบบนี้ เวลางานออกมาไม่ดีเราไล่แก้เป็นจุดได้: เครื่องมือพอไหม บริบทถูกไหม สิทธิ์เปิดถูกไหม แทนที่จะโทษโมเดลทั้งก้อน บ่อยครั้งแก้ที่ harness แล้วดีขึ้นทันที Osmani เรียกวิธีนี้ว่า ratchet — ทุกความผิดพลาดของ agent กลายเป็นกฎถาวรใน harness
แล้ว "loop engineering" ที่ทุกคนพูดถึงคืออะไร?

กลางปี 2026 คำว่า loop engineering แพร่ไปทั่ว แนวคิดคือแทนที่จะพิมพ์สั่ง agent ทีละคำสั่ง เราออกแบบ "วงจร" ที่มันหางานเอง แจกงาน ตรวจผล และตัดสินใจก้าวต่อไปเองจนถึงเป้า ฟังดูเหมือนของใหม่ แต่มันคือ ชิ้นที่ผลิตความอัตโนมัติ ของ harness ไม่ใช่สิ่งที่มาแทน harness
ตัว loop จริงๆ เล็กกว่าที่คิดมาก หัวใจของมันคือ while ลูปอันเดียว:
while True:
    resp = call_model(messages, tools)       # โมเดล "ตัดสินใจ"
    if resp.stop_reason != "tool_use":
        break                                # โมเดลตอบเสร็จ
    results = [run_tool(b) for b in resp.tool_calls]  # harness "ลงมือ"
    messages += [resp, results]
โค้ดนี้วิ่งเองได้ แต่ลองดูสิ่งที่ ไม่มี ในนั้น:
- สิทธิ์ —
run_toolจะอ่านไฟล์รายงานก็ได้ อ่านกุญแจ SSH ก็ได้ ถ้าโมเดลถูกหลอกให้ขอ - การตรวจงาน — ไม่มีอะไรเช็กว่าคำตอบตรงกับไฟล์จริงไหม มันจะแต่งตัวเลขก็ได้
- บริบท — ถ้าวน 200 รอบ บริบทบวมจนเกินหน้าต่างแล้วพัง
- log — ย้อนดูไม่ได้ว่ามันทำอะไรไปบ้าง
- เบรก — ถ้ามันวนแก้ของเดิมไม่เลิก ไม่มีตัวตัด
Loop ทำให้ agent วิ่งเองได้ แต่ทุกอย่างที่ทำให้มันวิ่งอย่างปลอดภัยและตรวจสอบได้ อยู่นอก loop ถ้าเก่งแค่ loop เราจะได้ agent ที่วิ่งเข้ากำแพงได้อย่างมีประสิทธิภาพมาก
ตรวจงานก่อนเชื่อ อยู่ตรงไหนของ harness?
ในระบบที่ผมใช้สร้าง Terminal แผนงานหรือบทสรุปที่มีผลต่อการตัดสินใจ ต้องผ่าน adversarial gate ก่อน คือส่งให้โมเดลอีกตัวโจมตีแผนในมุมสมมติฐานและมุม edge case แล้วค่อยแก้ ด่านนี้ถูกบันทึกไว้แล้ว 293 ครั้ง ตั้งแต่ 26 พ.ค. 2026 นี่คือชิ้น "ตรวจงาน" ที่ไม่มีใน while ลูป แต่เป็นเหตุผลที่แผนหลายชิ้นไม่พังตอนลงมือจริง
ตัว product เองก็ใช้หลักเดียวกัน — ทุกผลค้นหาใน Terminal ต้องชี้กลับไปที่เลขหน้าในเอกสารต้นฉบับได้ อะไรที่ตรวจย้อนไม่ได้ถูกตัดทิ้งก่อนถึงหน้าจอ กฎนั้นไม่ได้อยู่ในโมเดล มันอยู่ในโค้ดที่หุ้มโมเดล
ทำไมเรื่องนี้สำคัญกับคนสร้าง product การเงิน?
คำถามที่ผู้ตรวจหรือทีม risk ถามเสมอ — ระบบเข้าถึงข้อมูลแค่ไหน ใครอนุมัติก่อนลงมือ มี log ไหม กดหยุดได้ไหม — ตอบได้ที่ชั้น harness ทั้งหมด ไม่ใช่ที่โมเดล ข่าวดีคือชั้นที่ให้ leverage สูงสุดคือชั้นที่ เราคุมเองได้ ข่าวที่ต้องระวังคือความเสี่ยงก็อยู่ชั้นนี้เหมือนกัน
สิ่งที่ผมเปลี่ยนวิธีทำงานจริงจากหลักฐานชุดนี้:
- อย่า validate โมเดลเดี่ยวๆ ผลทดสอบที่ผูกกับ harness เดิม ใช้อ้างกับ harness ใหม่ไม่ได้
- บันทึกเวอร์ชัน harness เหมือนบันทึกเวอร์ชันโมเดล เพราะมันเปลี่ยนผลได้พอๆ กัน
- วาง control ที่ชั้น harness — ขอบเขตสิทธิ์ ด่านอนุมัติ log และเบรก
- ระวังการเทียบ "โมเดล A ดีกว่า B" ถ้าทดสอบคนละ harness การเทียบนั้นไม่ยุติธรรม
เริ่มคิดแบบ harness ได้ยังไงตั้งแต่วันนี้?
ไม่ต้องเขียนโค้ดซับซ้อน แค่ถาม 3 ข้อกับงานทุกชิ้นที่จะให้ agent ทำ:
- งานนี้ต้องใช้ เครื่องมือ อะไร และเปิดให้แค่ที่จำเป็นหรือยัง
- ป้อน บริบท ที่ตรงและพอดีแล้วหรือยัง
- จุดไหนที่ ต้องมีคนเคาะ ก่อนลงมือ
ถามสามข้อนี้จนเป็นนิสัย เราจะออกแบบงานให้ agent ได้ดีขึ้นทันที และเข้าใจว่าทำไมเครื่องมือสองตัวที่ใช้โมเดลเดียวกันถึงให้ผลคนละเรื่อง