ทำไมผมสร้าง Terminal ด้วย Claude Code — ไม่ใช่เพราะโมเดลเก่งสุด แต่เพราะ harness
5 เดือน 1,469 commits ใน 5 repo — สิ่งที่ทำให้ AI agent สร้าง fintech product ได้จริงไม่ใช่คะแนนของโมเดล แต่คือ harness รอบตัวมัน: กฎที่มันต้องอ่าน ด่านที่มันผ่านไม่ได้ และวงจรที่มันต้องตรวจงานตัวเอง นี่คือเหตุผลและของจริงที่ผมใช้
โดย วรัญชัย ยิ่งคำนึง (Boom) · เผยแพร่ครั้งแรก · ตรวจทานล่าสุด

เวลามีคนถามว่า "ใช้ AI ตัวไหน ตัวไหนเก่งสุด" ผมมักตอบว่าผมไม่ได้เลือกจากความเก่งของโมเดลเป็นหลัก ผมเลือกจาก harness คำตอบนี้ฟังดูทวนกระแส เพราะข่าวเกือบทั้งหมดพาดหัวว่า "โมเดลใหม่ทุบสถิติ" แต่ตลอด 5 เดือนที่ผมใช้ AI agent สร้าง Boom Leverage Terminal — เครื่องมือค้นเอกสาร 56-1 และ MD&A ทั้งตลาดหุ้นไทยพร้อมเลขหน้าต้นฉบับ — สิ่งที่ตัดสินว่างานเดินหรือพัง แทบไม่เคยอยู่ที่ตัวโมเดล
ถ้ายังไม่คุ้นคำนี้ อ่านคู่กับ Harness คืออะไร — ทำไมความเก่งของ AI agent ส่วนใหญ่อยู่นอกตัวโมเดล ได้ สั้นที่สุดคือ ถ้าโมเดลคือสมอง harness คือร่างกายกับกฎที่ทำให้สมองนั้นลงมือทำงานในโลกจริงได้
ทำไมไม่เลือกเครื่องมือ AI จากกระดานคะแนน?
เพราะมันเป็นเป้าที่ขยับทุกเดือน และคะแนนบน benchmark ไม่ใช่งานของผม
สนามทดสอบสะอาด มีโจทย์ชัด มีเฉลย แต่งานจริงตอนสร้าง Terminal คือ "แก้ pipeline ที่ดึงเอกสาร 56-1 โดยไม่ทำให้ index ที่ลูกค้าใช้อยู่พัง แล้วพิสูจน์ว่าไม่พังก่อน deploy" งานแบบนี้ความเก่งดิบของโมเดลเป็นแค่ส่วนหนึ่ง ที่เหลือคือ มันรู้ไหมว่ากฎของโปรเจกต์นี้คืออะไร มันถูกห้ามทำอะไร และมันตรวจงานตัวเองก่อนบอกว่าเสร็จหรือเปล่า — ทั้งหมดนั้นเป็นเรื่องของ harness
มีต้นทุนที่มองไม่เห็นด้วย ทุกครั้งที่ย้ายเครื่องมือตาม "โมเดลเก่งสุดประจำเดือน" เราต้องปรับสำนวนสั่งงานใหม่ ตั้งค่าใหม่ และระวังนิสัยเสียชุดใหม่ของมัน คนทำ model validation อย่างผมมองเรื่องนี้ง่ายๆ: เราไม่ validate โมเดลเปล่าๆ เราต้อง validate โมเดล + สิ่งที่หุ้มมัน เป็นคู่
Harness ของผมหน้าตาเป็นยังไง (ตัวเลขจริง)
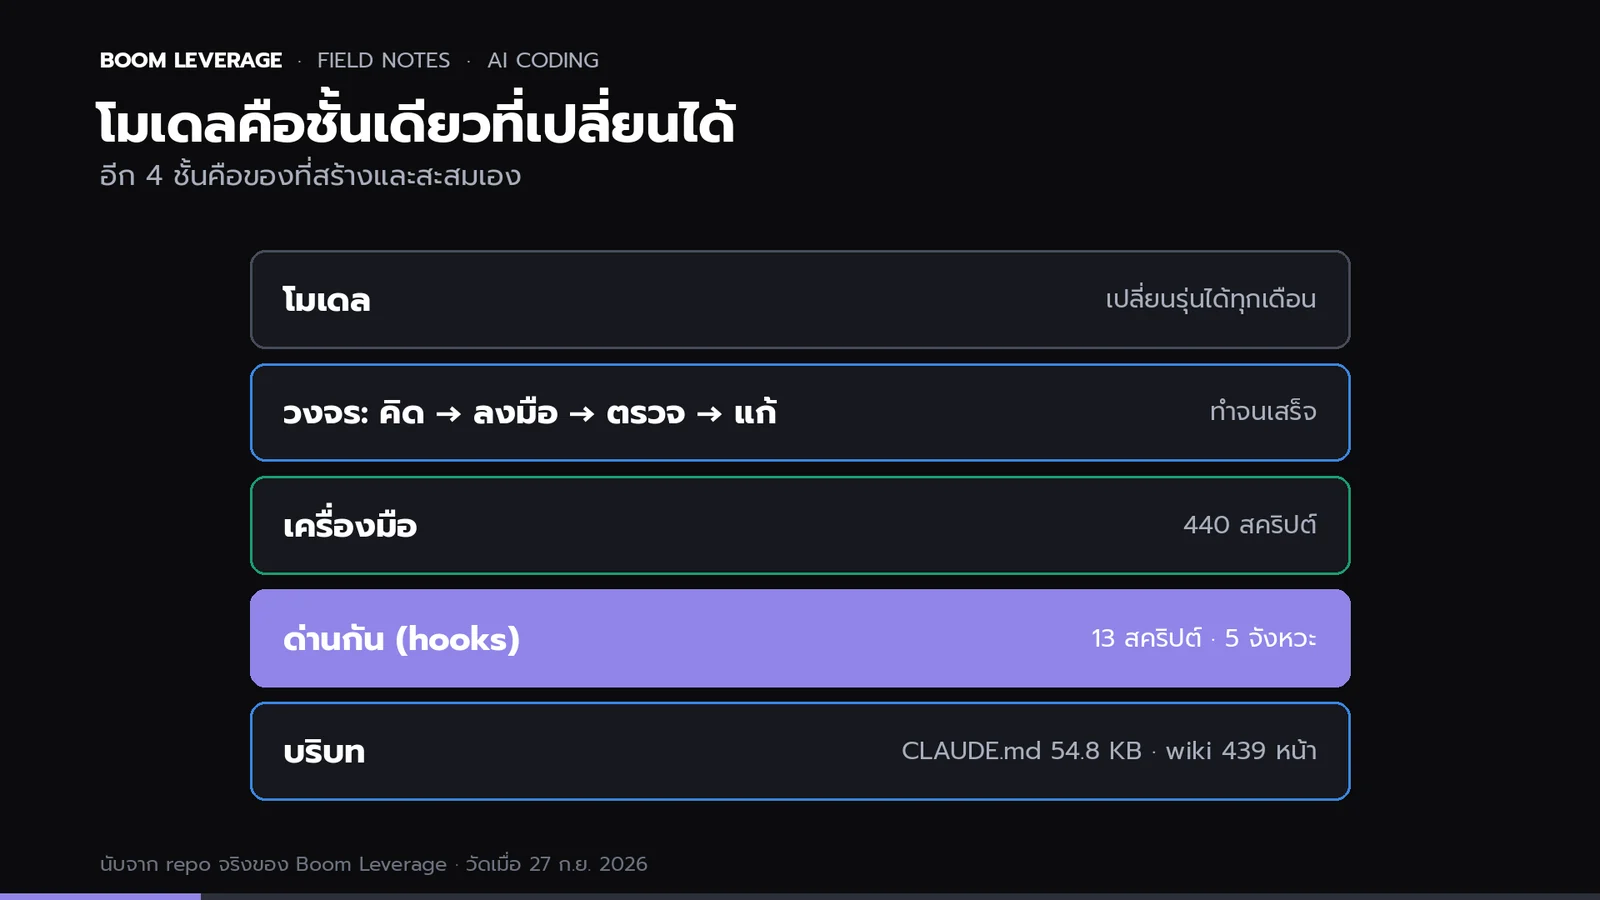
ผมแบ่ง harness ที่ใช้จริงออกเป็น 5 ชั้น นับจากล่างขึ้นบน:
| ชั้น | ของจริงในระบบ | ทำหน้าที่อะไร |
|---|---|---|
| บริบท (Context) | CLAUDE.md 54.8 KB + wiki 439 หน้า | กฎและความรู้ที่ agent โหลดทุก session โดยผมไม่ต้องเล่าใหม่ |
| ด่านกัน (Guardrails) | hook 13 สคริปต์ ดัก 5 จังหวะ | บังคับกติกาด้วยเครื่อง ไม่ใช่ด้วยการหวังว่ามันจะจำ |
| เครื่องมือ (Tools) | 440 สคริปต์ใน tools/ | งานที่พิสูจน์แล้วว่าทำซ้ำได้ ถูกแปลงเป็นคำสั่งเดียว |
| วงจร (Loop) | คิด → ลงมือ → ตรวจ → แก้ | ทำงานเป็นเป้าหมายจนเสร็จ ไม่ใช่ตอบทีละคำถาม |
| โมเดล | เปลี่ยนรุ่นได้ | สมอง — ชั้นเดียวที่ผมไม่ได้ลงแรงสร้างเอง |
สังเกตว่า 4 ใน 5 ชั้นเป็นของที่ผม สร้างและสะสม ขึ้นมาเอง มีแค่ชั้นบนสุดที่ผู้ให้บริการส่งมาให้ นี่คือเหตุผลทั้งหมดของบทความนี้ในตารางเดียว
โมเดลคือของที่เปลี่ยนได้ harness คือที่ที่ทักษะสะสม
ผมมองแบบนักลงทุน: โมเดลเป็น commodity — มีหลายเจ้า ราคาลงเรื่อยๆ พรุ่งนี้ก็มีตัวใหม่ ส่วน harness คือสินทรัพย์ที่ทบต้น ทุกชั่วโมงที่ผมใช้ทดลองว่าจะเขียนกฎยังไงให้ agent เข้าใจงาน จะวางด่านยังไงให้มันพลาดไม่ได้ ความรู้พวกนี้ไม่หายไปเมื่อโมเดลเปลี่ยนรุ่น

ตัวเลข 1,469 commits ใน 5 repo ภายในราว 5 เดือนไม่ได้บอกว่าโมเดลเก่ง มันบอกว่า วงจรทำงานเดินต่อเนื่องได้ โดยไม่พังกลางทางบ่อยจนต้องเริ่มใหม่ ซึ่งเป็นผลของ harness:
| Repo | commits | หน้าที่ |
|---|---|---|
| เว็บการตลาด (boomleverage.com) | 622 | หน้าขาย บทความ SEO |
| แอป Terminal | 323 | หน้าค้นหาที่ลูกค้าใช้ |
| data pipeline | 303 | ดึง/อ่าน/ทำ index เอกสาร 56-1 และ MD&A |
| กฎ + wiki ของ lab | 201 | CLAUDE.md, hook, เครื่องมือ |
| Boom Field Lab | 20 | เว็บ workshop นี้ |
5 อย่างใน harness ของ Claude Code ที่ผมใช้ทุกวัน
- วงจรที่ลงมือทำจริง — สั่งเป็นเป้าหมาย แล้วมันวนเอง: เปิดไฟล์ → รันคำสั่ง → เห็นผล → แก้ จนเสร็จ นี่คือเส้นแบ่งระหว่าง "ผู้ช่วยที่พิมพ์ตอบ" กับ "agent ที่ทำงานเสร็จ"
- สิทธิ์ (permission) ที่เป็นเบรกจริง — กำหนดได้ว่าคำสั่งไหนทำเองได้ คำสั่งไหนต้องรอผมเคาะ สำหรับงานที่แตะเงินลูกค้าและข้อมูล นี่ไม่ใช่ลูกเล่น
- บริบทที่ทำซ้ำได้ผ่าน CLAUDE.md — เขียนกฎครั้งเดียว ทุก session โหลดเอง ไม่ต้องเล่าใหม่ทุกเช้า
- hook ที่ทำให้ระบบไม่พึ่งความขยันของผม — แทรกขั้นบังคับกลางทางได้ เช่น ก่อนรันคำสั่ง shell ทุกครั้ง หรือก่อนปิด session
- ต่อข้อมูลจริงและแตกงานเป็นทีมได้ — ต่อเครื่องมือภายนอกผ่าน MCP และแตกงานใหญ่ให้ subagent ทำขนานกัน
ไม่มีข้อไหนเลยที่เป็นเรื่อง "โมเดลฉลาดแค่ไหน" ทุกข้อคือเปลือกที่หุ้มโมเดล
Hook ทำงานยังไงในชีวิตจริง?
ตัวอย่างที่ดีที่สุดเกิดขึ้นระหว่างเขียนบทความนี้เอง ผมให้ agent หาว่ามีค่าตั้งค่าของ CDN อยู่ในเครื่องหรือยัง มันพยายามค้นในไฟล์เก็บความลับแบบอ่านทั้งก้อน — แล้ว hook ตัวหนึ่งตัดคำสั่งทิ้งก่อนรัน พร้อมข้อความนี้:

[secret-guard] อ่านไฟล์ลับทั้งก้อน (.secrets/*.env/.env.local/id_ed25519/*.pem) โดยไม่ redact — ต่อท้ายด้วย | sed 's/=.*/=<redacted>/' หรือ cut -d= -f1 / sha256sum / wc / stat แทน
สิ่งที่น่าสนใจไม่ใช่ว่า agent พลาด (มันพลาดได้เสมอ) แต่คือ ความผิดพลาดไม่มีโอกาสกลายเป็นความเสียหาย เพราะด่านอยู่ที่ harness ไม่ได้อยู่ที่ความระมัดระวังของโมเดล agent อ่านข้อความแล้วเขียนคำสั่งใหม่เป็นแบบดึงแค่ชื่อตัวแปร (ตัดค่าทิ้ง) เองทันที
อีกกฎที่ผมใช้คือ ห้ามลบไฟล์ถาวร กฎในไฟล์ CLAUDE.md เขียนไว้ตรงๆ ว่า:
ห้าม
rm—mv→.archive/YYYY-MM-DD/(mirror โครงสร้าง path เดิม)
agent ที่ลบไฟล์พลาดคือหายนะ agent ที่ย้ายไฟล์ไปถังพักคือเรื่องที่กู้คืนได้ใน 10 วินาที ต่างกันแค่กฎบรรทัดเดียว
ทำไมเรื่องนี้หนักเป็นพิเศษกับการสร้าง product การเงิน?
ในโลก risk ความเก่งไม่ใช่ทุกอย่าง คำถามที่ผู้ตรวจถามเสมอ — ระบบเข้าถึงข้อมูลแค่ไหน ใครอนุมัติก่อนลงมือ มี log ไหม กดหยุดได้ไหม — ทุกข้อตอบได้ที่ชั้น harness ไม่ใช่ที่ตัวโมเดล
พอ product ของเราคือเครื่องมือที่คนใช้ตัดสินใจเรื่องเงิน ความผิดพลาดแบบ "AI แต่งตัวเลข" หรือ "AI ลบข้อมูลลูกค้า" ไม่ใช่บั๊กธรรมดา มันคือความน่าเชื่อถือของทั้งบริษัท การเลือกเครื่องมือที่ให้เราวางด่านได้เองจึงไม่ใช่เรื่องประสิทธิภาพ แต่เป็นเรื่อง การกำกับที่จับต้องได้
แล้วถ้าวันหนึ่งมีโมเดลที่เก่งกว่าล่ะ?
ดีเลย เพราะเมื่อเลือกที่ harness โมเดลกลายเป็นชิ้นส่วนที่ถอดเปลี่ยนได้ พอมีรุ่นใหม่ที่เก่งกว่าหรือถูกกว่า CLAUDE.md, hook, เครื่องมือ 440 ตัว และ wiki 439 หน้าของผมยังอยู่ครบ แต่สมองข้างในแรงขึ้น — ได้อัปเกรดโดยไม่ต้องรื้อระบบ
ถ้าเลือกที่โมเดล ทุกครั้งที่มีตัวใหม่ต้องชั่งใจว่าจะย้ายไหม และถ้าย้ายก็ต้องประกอบ harness ใหม่หมด นี่คือความต่างระหว่างการ bet ที่ตัวแปรที่ขยับตลอด กับ bet ที่โครงสร้างที่อยู่กับเรา
สรุป
ผมไม่ได้เลือก Claude Code เพราะเชื่อว่าโมเดลข้างในเก่งที่สุดตลอดกาล ไม่มีใครการันตีได้และไม่ใช่ประเด็น ผมเลือกเพราะ harness ของมันให้สิ่งที่การสร้าง product การเงินต้องการ: วงจรที่ทำงานจนเสร็จ ด่านที่ความผิดพลาดข้ามไม่ได้ บริบทที่ทำซ้ำได้ และโครงสร้างที่ทักษะผมทบต้นอยู่ในนั้น
ถ้าจะเลือกเครื่องมือ AI มาทำงานจริงจัง ลองเปลี่ยนคำถามจาก "ตัวไหนเก่งสุด" เป็น "harness ตัวไหนที่ผมคุมได้และอยู่ด้วยได้นาน"
ถ้ากำลังเทียบเครื่องมืออยู่ อ่าน Claude Code vs Codex vs Cursor vs Copilot และถ้าตัดสินใจแล้ว เริ่มได้ที่ เริ่มใช้ Claude Code แบบคนการเงิน
คำถามที่พบบ่อย
- harness ของ AI agent คืออะไร
- harness คือเปลือกรอบโมเดล ได้แก่ บริบท สิทธิ์ hook เครื่องมือ และวงจรทำงาน ถ้าโมเดลคือสมอง harness คือร่างกายกับกฎที่ทำให้สมองนั้นลงมือทำงานในโลกจริงได้
- ทำไมไม่ควรเลือกเครื่องมือ AI coding จากกระดานคะแนน benchmark อย่างเดียว
- เพราะโมเดลแซงกันทุกเดือนและคะแนน benchmark ไม่ใช่งานจริง งานจริงต้องการให้ agent รู้กฎของโปรเจกต์ รู้ว่าถูกห้ามทำอะไร และตรวจงานตัวเองก่อนบอกว่าเสร็จ ซึ่งเป็นเรื่องของ harness นอกจากนี้การย้ายเครื่องมือบ่อยยังมีต้นทุนที่ต้องปรับวิธีสั่งงานและตั้งค่าใหม่
- harness ที่ใช้สร้าง Boom Leverage Terminal มีกี่ชั้นและมีอะไรบ้าง
- มี 5 ชั้น คือบริบท (CLAUDE.md กับ wiki) ด่านกัน (hook) เครื่องมือ (สคริปต์ใน tools) วงจรทำงาน และโมเดล ตามตัวเลขที่วัดเมื่อ 27 ก.ย. 2026 มี CLAUDE.md 54.8 KB wiki 439 หน้า hook 13 สคริปต์ดัก 5 จังหวะ และเครื่องมือ 440 สคริปต์ โดยโมเดลเป็นชั้นเดียวที่เปลี่ยนได้โดยไม่ต้องรื้ออะไร
- hook ใน Claude Code ช่วยกันความผิดพลาดได้อย่างไร
- hook แทรกขั้นบังคับกลางทาง เช่น ก่อนรันคำสั่ง shell ทำให้กติกาถูกบังคับด้วยเครื่องแทนการหวังว่า agent จะจำ ตัวอย่างในบทความคือ hook secret-guard ตัดคำสั่งที่พยายามอ่านไฟล์ลับทั้งก้อนก่อนรัน และ agent แก้คำสั่งเองเป็นแบบดึงแค่ชื่อตัวแปร
- ทำไม harness สำคัญเป็นพิเศษกับการสร้าง product การเงิน
- เพราะคำถามด้านการกำกับ เช่น ระบบเข้าถึงข้อมูลแค่ไหน ใครอนุมัติก่อนลงมือ มี log ไหม และกดหยุดได้ไหม ล้วนตอบได้ที่ชั้น harness ไม่ใช่ที่ตัวโมเดล ความผิดพลาดอย่าง AI แต่งตัวเลขหรือลบข้อมูลลูกค้ากระทบความน่าเชื่อถือของทั้งบริษัท