ใช้ AI agent หลายตัวพร้อมกันเมื่อไหร่ถึงคุ้ม — บันทึกจริงจากการให้ 4 agent เขียนบทความขนานกัน
agent หลายตัวไม่ได้แปลว่าฉลาดขึ้น แต่ถ้างานแตกเป็นชิ้นอิสระได้จริง มันเร็วขึ้นมาก ตัวเลขจริงจากเว็บนี้: 4 agent เขียน 4 บทความขนานกันจบใน 259 วินาที แทนที่จะเป็น 876 วินาทีถ้าทำทีละชิ้น — แลกกับ token รวมราว 1.32 ล้าน และกติกาเดียวที่กันไม่ให้มันชนกัน
โดย วรัญชัย ยิ่งคำนึง (Boom) · เผยแพร่ครั้งแรก · ตรวจทานล่าสุด
บทความ 5 ชิ้นแรกบน Field Notes นี้ ผมเขียนเองชิ้นเดียว อีก 4 ชิ้นให้ agent 4 ตัวเขียนพร้อมกัน แต่ละตัวได้โจทย์ต่างกัน ได้บทความตัวอย่างชิ้นแรกเป็นแม่แบบ แล้วรายงานกลับมาให้ตรวจ นี่คือตัวเลขจริงของรอบนั้น และสิ่งที่ผมได้รู้ว่าการใช้ agent หลายตัวคุ้มตอนไหน — และไม่คุ้มตอนไหน
agent หลายตัวทำให้ AI ฉลาดขึ้นไหม?
ไม่ใช่ในความหมายที่คนส่วนใหญ่คิด ความเข้าใจผิดที่พบบ่อยคือ "ให้ agent หลายตัวคุยกัน เดี๋ยวคำตอบจะดีขึ้นเอง" ในทางปฏิบัติ agent ที่คุยกันเองโดยไม่มีโครงสร้างมักจะ เห็นด้วยกันเองจนผิดทั้งกลุ่ม หรือ ทำงานซ้ำและเขียนทับกัน
สิ่งที่ agent หลายตัวให้จริงคือ ความขนาน ทีม Anthropic ที่สร้างระบบ research แบบหลาย agent รายงานว่าระบบนี้ทำได้ดีกว่า agent ตัวเดียวถึง 90.2% ในงาน research แต่ก็เขียนไว้ชัดว่ามันกิน token ราว 15 เท่าของการแชตปกติ และงานเขียนโค้ดส่วนใหญ่แตกขนานได้น้อยกว่างาน research (Anthropic Engineering, 13 มิ.ย. 2025, ตรวจ 27 ก.ย. 2026)
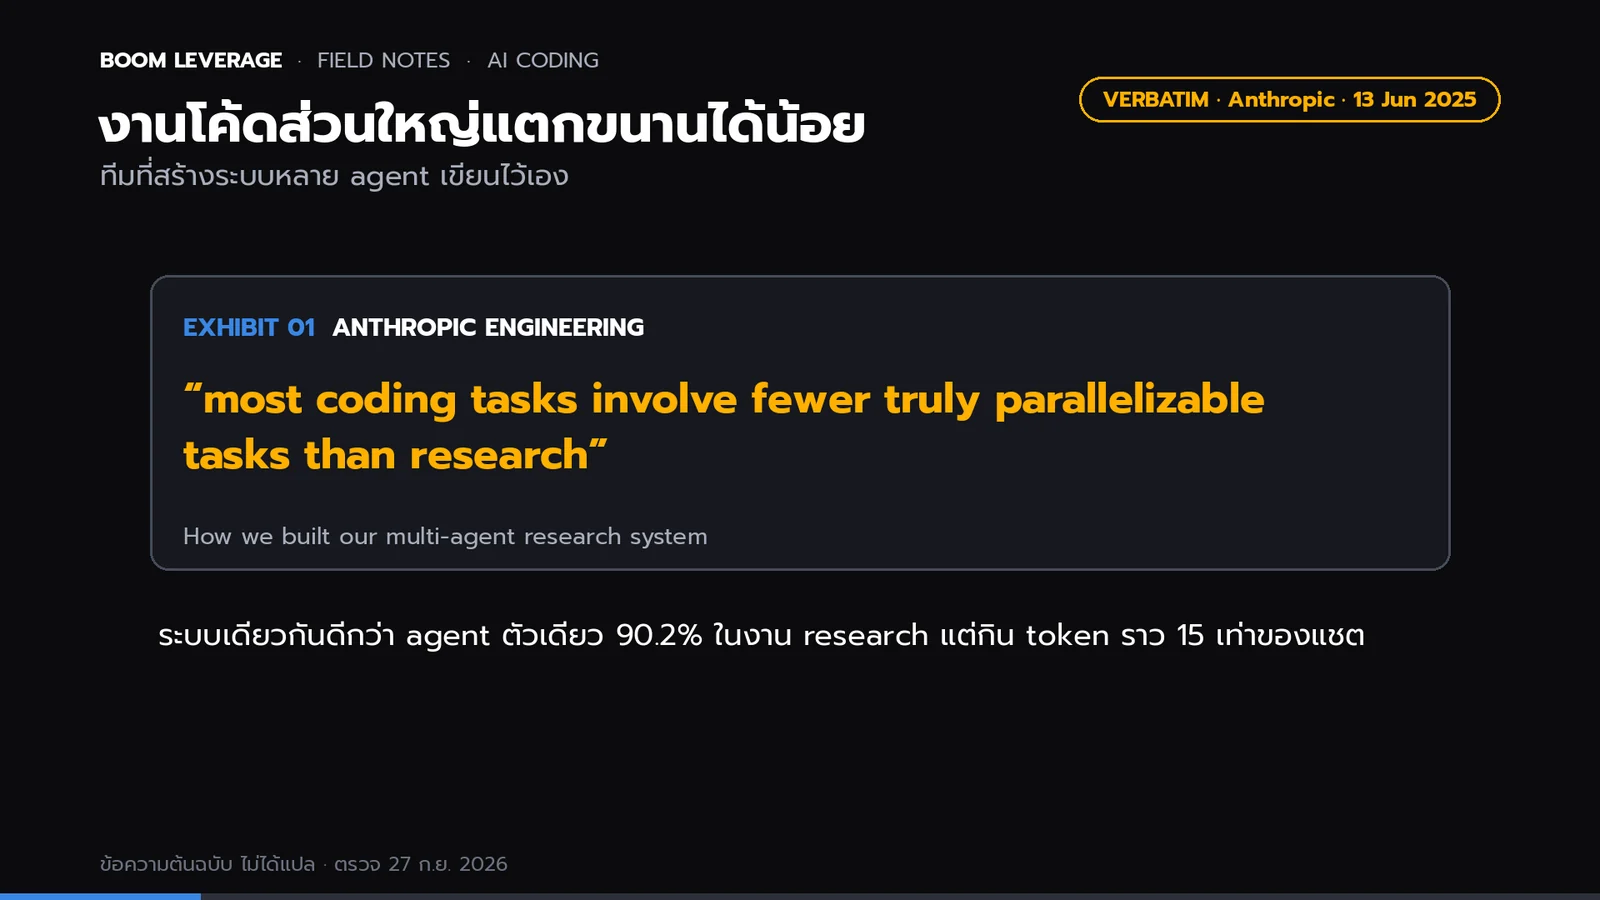
most coding tasks involve fewer truly parallelizable tasks than research
งานแบบไหนที่แตกให้หลาย agent ได้คุ้ม?
เกณฑ์ที่ผมใช้มีข้อเดียว: ชิ้นงานแต่ละชิ้นต้องทำจนเสร็จได้โดยไม่ต้องรู้ผลของชิ้นอื่น
| งาน | แตกได้ไหม | เหตุผล |
|---|---|---|
| เขียนบทความ 4 เรื่องที่ต่างหัวข้อกัน | ได้ดี | แต่ละชิ้นอิสระ ใช้แม่แบบเดียวกันได้ |
| ค้นข้อมูลหลายแหล่งมาเทียบ | ได้ดี | ค้นขนาน แล้วคนเดียวสังเคราะห์ |
| แก้บั๊กที่ไฟล์หลายไฟล์พันกัน | ไม่ค่อยได้ | ทุกการแก้กระทบกัน ต้องรู้บริบทเดียวกัน |
| ออกแบบ schema แล้วเขียนโค้ดตาม | ไม่ได้ | ขั้นหลังต้องรอผลขั้นแรก |
บทความ 4 ชิ้นรอบนั้นผ่านเกณฑ์ชัด: คนละหัวข้อ คนละไฟล์ ใช้แม่แบบกับเครื่องมือทำรูปชุดเดียวกัน
ตัวเลขจริงของรอบนั้นเป็นยังไง?
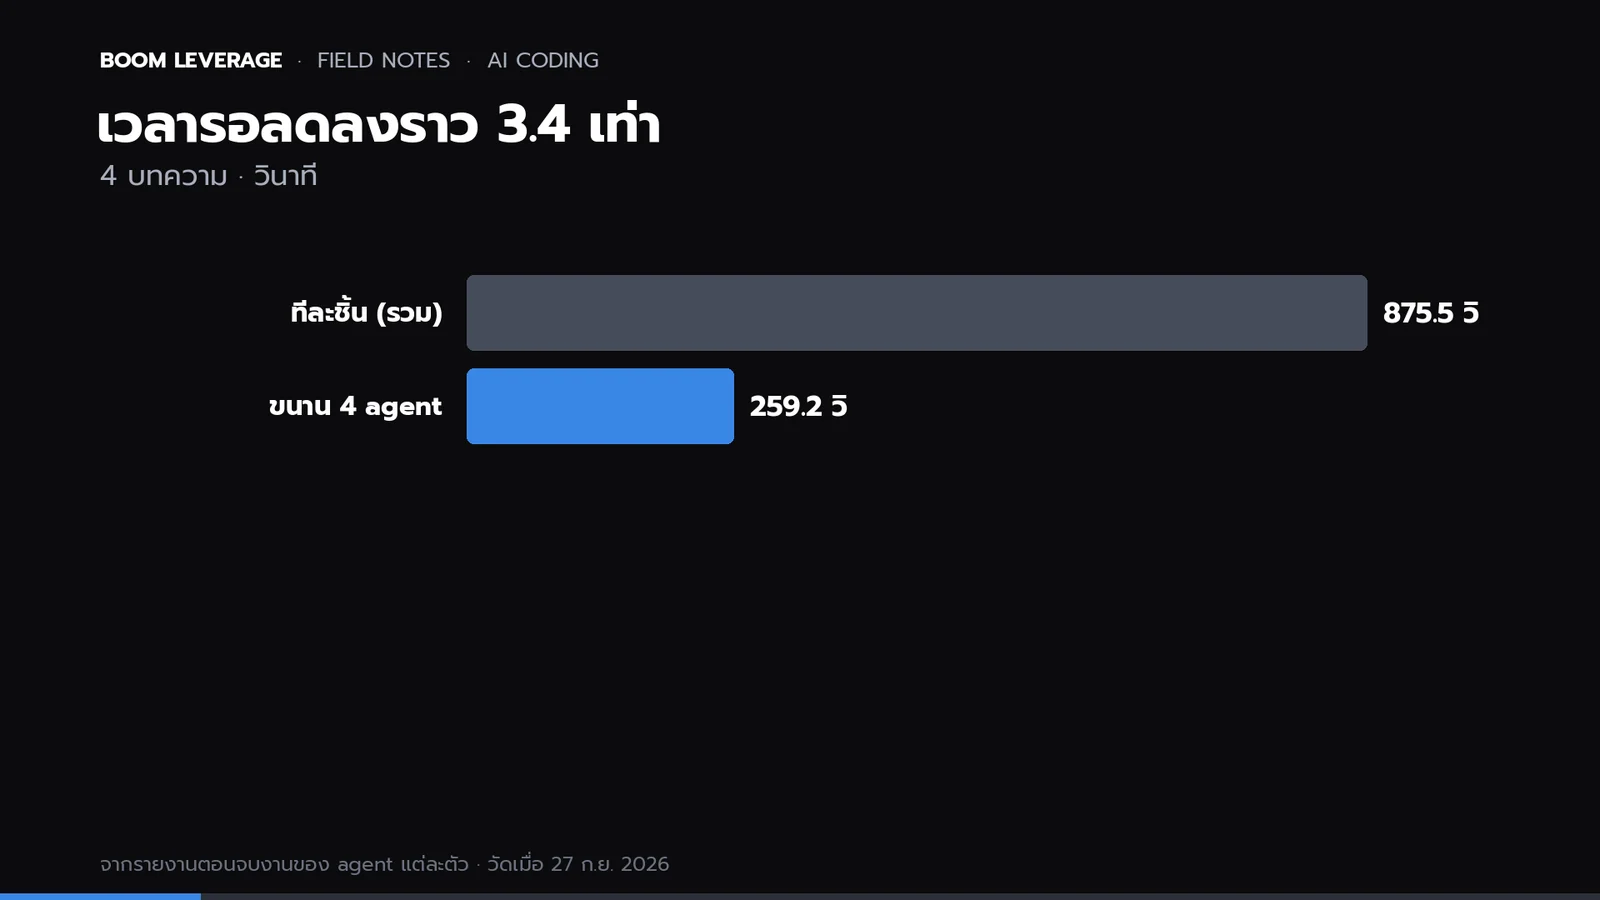
| agent | งาน | เวลา (วินาที) | token |
|---|---|---|---|
| 1 | Harness คืออะไร | 200.0 | 333,146 |
| 2 | ระบบรับเงิน Stripe + PromptPay | 197.7 | 335,432 |
| 3 | Mux vs Bunny | 218.6 | 322,048 |
| 4 | อ่านงบ 3 มุม | 259.2 | 328,344 |
| รวม | 875.5 (ขนานรอจริง 259.2) | 1,318,970 |
ผลคือ เวลารอลดลงราว 3.4 เท่า (875.5 ÷ 259.2) แต่ token ไม่ได้ลด — แต่ละ agent ใช้ราว 3.2–3.4 แสน token เพราะต้องอ่านบริบท แม่แบบ และไฟล์ต้นฉบับของตัวเอง ถ้าทำทีละชิ้นในบริบทเดียว บางส่วนจะใช้ซ้ำได้

นี่คือ trade-off ที่ต้องตัดสินใจทุกครั้ง: จ่าย token เพื่อซื้อเวลา ในงานที่รอคนตรวจต่อ (เช่นรอบนี้ที่ต้องส่งให้ Boom ตรวจภายในวัน) มันคุ้ม ในงานที่ไม่รีบ ทำทีละชิ้นถูกกว่า
อะไรที่ทำให้ agent หลายตัวชนกันจนพัง?
ไฟล์ที่ใช้ร่วมกัน นี่คือจุดพังอันดับหนึ่ง ในรอบนั้น agent ทั้ง 4 ใช้เครื่องมือทำรูปตัวเดียวกัน ถ้าตัวหนึ่งแก้เครื่องมือกลางคัน อีกสามตัวที่กำลังเรนเดอร์อยู่จะได้ผลเพี้ยนโดยไม่รู้ตัว
กติกาที่ผมใส่ในโจทย์ของทุกตัวคือ ห้ามแก้ไฟล์ร่วม ถ้าเจอปัญหาให้รายงานกลับ และมันได้ผลจริง: agent ตัวหนึ่งเจอบั๊กการตัดบรรทัด (คำภาษาอังกฤษที่มีขีดเชื่อมถูกตัดกลางคำ) มันไม่แก้เอง แต่เขียนไว้ในรายงาน ผมแก้ที่เครื่องมือกลางจุดเดียว แล้วเรนเดอร์ใหม่
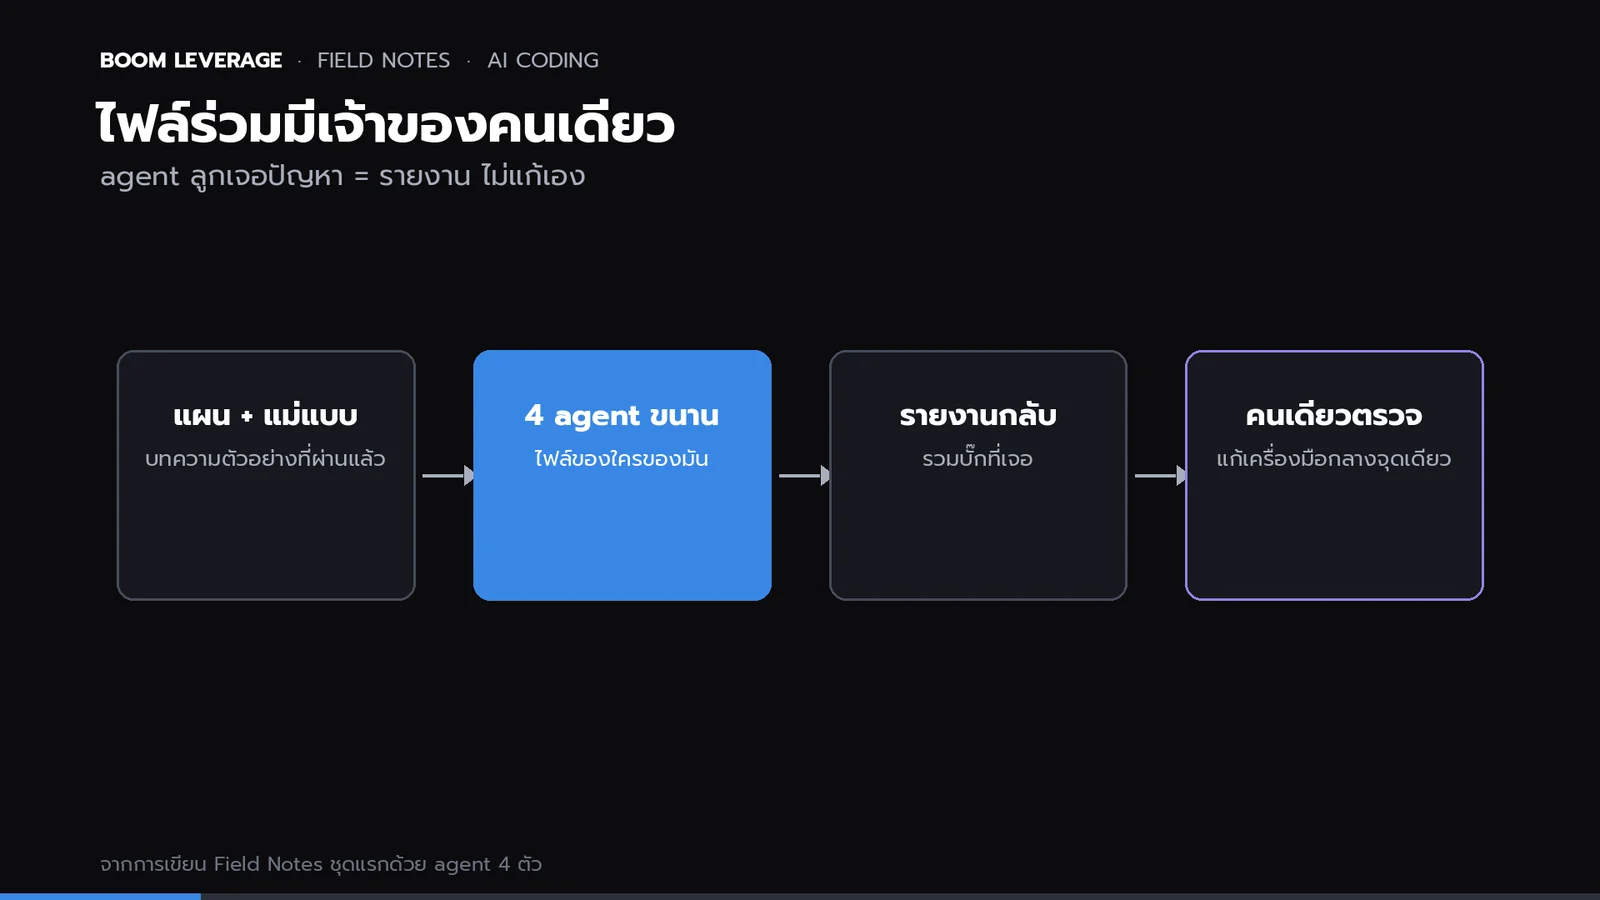
กติกาอื่นที่ใช้ร่วมกัน:
- แม่แบบเดียว — ให้บทความตัวอย่างที่ผ่านการตรวจแล้วเป็นมาตรฐาน ดีกว่าอธิบายสไตล์เป็นย่อหน้า
- เขียนเฉพาะไฟล์ของตัวเอง — ชื่อไฟล์ output ถูกกำหนดในโจทย์ ไม่มีสองตัวเขียนที่เดียวกัน
- ตรวจสองชั้น — agent ตรวจงานตัวเอง (ดูรูปทุกใบ เปิดหน้าเว็บให้ได้ 200) แล้วคนตรวจอีกรอบ รอบนั้นผมยังเจอคำต้องห้ามที่หลุดในบทความที่ผมเขียนเอง — คนก็พลาดได้ ด่านอัตโนมัติจึงสำคัญพอๆ กัน
สรุป
agent หลายตัวคือเครื่องมือซื้อเวลา ไม่ใช่เครื่องมือซื้อความฉลาด ใช้เมื่องานแตกเป็นชิ้นอิสระได้จริง ยอมจ่าย token เพิ่มได้ และมีคนคนเดียวเป็นเจ้าของทุกอย่างที่ใช้ร่วมกัน ถ้าขาดข้อใดข้อหนึ่ง agent ตัวเดียวที่ทำทีละขั้นมักจะดีกว่า
ถ้าอยากเห็นภาพรวมว่า agent ทำงานอยู่ในโครงอะไร อ่านต่อที่ Harness คืออะไร
คำถามที่พบบ่อย
- ใช้ AI agent หลายตัวพร้อมกันทำให้ AI ฉลาดขึ้นไหม
- ไม่ agent หลายตัวทำให้เร็วขึ้นเฉพาะเมื่องานแตกเป็นชิ้นที่ไม่ต้องรู้ผลของกันและกัน ส่วน agent ที่คุยกันเองโดยไม่มีโครงสร้างมักเห็นด้วยกันเองจนผิดทั้งกลุ่ม หรือทำงานซ้ำและเขียนทับกัน
- งานแบบไหนเหมาะจะแตกให้ subagent หลายตัวทำขนานกัน
- เกณฑ์คือแต่ละชิ้นต้องทำจนเสร็จได้โดยไม่ต้องรู้ผลของชิ้นอื่น เช่น เขียนบทความต่างหัวข้อ หรือค้นข้อมูลหลายแหล่งแล้วให้คนเดียวสังเคราะห์ ส่วนงานแก้บั๊กที่หลายไฟล์พันกัน หรือออกแบบ schema แล้วเขียนโค้ดตามซึ่งขั้นหลังต้องรอขั้นแรก ไม่เหมาะ
- ให้ 4 agent ทำงานขนานกันเร็วขึ้นเท่าไหร่ และแลกกับอะไร
- ในรอบวันที่ 27 ก.ย. 2026 agent 4 ตัวเขียน 4 บทความขนานกัน เวลารอจริง 259.2 วินาที เทียบกับ 875.5 วินาทีถ้าทำทีละชิ้น หรือเร็วขึ้นราว 3.4 เท่า แต่ token ไม่ได้ลด ใช้รวมราว 1.32 ล้าน เพราะแต่ละตัวต้องแบกบริบทของตัวเอง จึงคุ้มกับงานที่รีบ
- จะป้องกันไม่ให้ agent หลายตัวทำงานชนกันได้อย่างไร
- กติกาหลักคือไฟล์ที่ใช้ร่วมกันมีเจ้าของคนเดียว agent ลูกห้ามแก้ เจอปัญหาให้รายงานกลับ นอกจากนี้ใช้แม่แบบเดียวกัน กำหนดชื่อไฟล์ output ของแต่ละตัวในโจทย์ไม่ให้เขียนที่เดียวกัน และตรวจสองชั้นคือ agent ตรวจงานตัวเองแล้วคนตรวจอีกรอบ