RAG กับเอกสาร 56-1: สร้างระบบค้นที่ทุกคำตอบชี้กลับหน้าต้นฉบับได้ — และซ่อนทุกบรรทัดที่พิสูจน์ไม่ได้
ถาม AI ตรงๆ กับงบหรือแบบ 56-1 เสี่ยงได้ตัวเลขที่ฟังดูใช่แต่ผิด นี่คือวิธีที่ Boom Leverage Terminal ถูกสร้างให้ค้นเอกสารทั้งตลาดแล้วชี้กลับหน้าได้ทุกบรรทัด: ค้นตามความหมาย, floor คะแนน, และด่าน citation ที่เปิด PDF พิสูจน์ทีละประโยค พร้อมผลทดสอบกับ 'เอกสารผิด' ก่อนจะเชื่อ
โดย วรัญชัย ยิ่งคำนึง (Boom) · เผยแพร่ครั้งแรก · ตรวจทานล่าสุด
ถ้าเคยก็อปงบหรือแบบ 56-1 ยาวๆ ไปถาม AI ตรงๆ แล้วได้ตัวเลขที่ "ฟังดูใช่แต่ผิด" นั่นคืออาการหลอนที่อันตรายที่สุดในงานการเงิน เพราะมันผิดแบบเนียน บันทึกนี้เล่าว่า Boom Leverage Terminal ถูกสร้างยังไงให้ค้นเอกสารทั้งตลาดแล้ว ชี้กลับหน้าต้นฉบับได้ทุกบรรทัด — เล่าในระดับหลักการและตัวเลขจริง ไม่ลงรายละเอียดเครื่องและเครือข่าย
ทำไมถาม LLM ตรงๆ กับเอกสารการเงินถึงเสี่ยง?
LLM ตอบจากสิ่งที่มันจำได้ตอนฝึก ไม่ใช่จากไฟล์ที่เราถือ ถ้าเอกสารยาวเกินที่มันรับได้ หรือมันจำคลาดเคลื่อน มันมักจะ "เดาให้เนียน" แทนที่จะบอกว่าไม่รู้ งานทั่วไปอาจรับได้ แต่งานที่คนเอาไปตัดสินใจเรื่องเงินรับไม่ได้
RAG (Retrieval-Augmented Generation) แก้ตรงนี้: ค้นข้อความที่เกี่ยวข้องจากเอกสารจริงก่อน แล้วค่อยตอบจากข้อความนั้น เหมือนนักวิเคราะห์ที่ดีที่ไม่ตอบจากความจำลอยๆ แต่เปิดไปหน้าที่เกี่ยว อ่าน แล้วตอบพร้อมบอกว่า "อยู่หน้านี้"
แต่ RAG เปล่าๆ ยังไม่พอ ถ้าขั้น "ตอบ" ยังให้โมเดลเรียบเรียงใหม่ได้อิสระ มันก็ยังแต่งได้ Terminal จึงเลือกทางที่เข้มกว่า: แสดงข้อความต้นฉบับ ไม่ใช่คำตอบที่เรียบเรียงใหม่ และพิสูจน์ว่าข้อความนั้นอยู่ในเอกสารจริงก่อนแสดง
ระบบค้นของ Terminal ทำงานยังไง?

| ขั้น | ทำอะไร | ของจริงใน Terminal |
|---|---|---|
| 1. เอกสาร | ดึงแบบ 56-1 และ MD&A จากเว็บ ก.ล.ต. | เก็บไบต์ต้นฉบับไว้ ไม่แก้ไฟล์ |
| 2. สกัด | อ่านแล้วแยกเป็นข้อค้นพบ มีโดเมน ปี หน้า และข้อความต้นฉบับ | ช่วงหลัก FY2021–2026: 988,998 ข้อค้นพบ ใน 19 โดเมน (คลังย้อนหลังแยกอีก 381,072) · 27 ก.ย. 2026 |
| 3. เวกเตอร์ | แปลงข้อความเป็นเวกเตอร์เพื่อค้นตามความหมาย | โมเดล multilingual MiniLM ขนาด 384 มิติ |
| 4. ค้น + floor | หาใกล้ที่สุดตามความหมาย ตัดผลที่คะแนนต่ำกว่า floor | floor ถูกตั้งจากการวัดสัดส่วนผลที่ไม่เกี่ยว ไม่ใช่เดาเลข |
| 5. ด่าน citation | เปิด PDF หาประโยคนั้นให้เจอ | ผ่าน 98.95% · ไม่ผ่าน = ไม่แสดง |
รายละเอียดเล็กที่ช่วยเรื่องต้นทุนมาก: เวกเตอร์ถูก cache ตามเนื้อข้อความ รอบ build ล่าสุด (27 ก.ย. 2026) ต้องคำนวณใหม่แค่ 8 จากข้อค้นพบทั้ง index 1,370,116 ตัว (รวมคลังย้อนหลัง) ที่เหลือใช้ของเดิม
ด่าน citation ทำงานยังไง?
ข้อค้นพบทุกตัวใน Terminal อ้างว่า "ประโยคนี้อยู่ในเอกสารของบริษัทนี้จริง" ด่านนี้พยายามพิสูจน์คำอ้างนั้นทีละตัว:
- จัดกลุ่มตามเอกสาร — เปิดและตัดคำ PDF แต่ละไฟล์ครั้งเดียว แล้วตรวจทุกข้อค้นพบของไฟล์นั้น (ต่างกันระหว่างหลักนาทีกับหลักวัน)
- ใช้ตัวจับคู่ตัวเดียวกับไฮไลต์บนหน้าจอ — ข้อค้นพบที่ผ่านด่าน คือข้อค้นพบที่ระบบวาดกรอบบนหน้า PDF ได้จริง ไม่มีการ drift ระหว่างสองที่
- ไฟล์สแกนเป็นคำตัดสินแยก — ไฟล์ที่ไม่มีชั้นข้อความถูกบันทึกเป็น "ไม่มีชั้นข้อความ" ไม่ใช่ "หาไม่เจอ" เพื่อไม่ให้ขนาดของงานค้างถูกซ่อน
- เกือบตรง ≠ ผ่าน — ประโยคที่ตรงไม่ครบคำถูกให้คะแนนความใกล้ (ถ่วงด้วยความหายากของคำ เพื่อให้ภาษาพิธีกรรมที่ทุกบริษัทเขียนเหมือนกันช่วยไม่ได้) แต่ยังถูกซ่อนอยู่ดี

Near misses are scored, not admitted.
ผลคือตัวเลขที่วัดได้ ไม่ใช่สมมติฐาน: ณ 27 ก.ย. 2026 ใน 5 โดเมนที่เปิดเผยแพร่ (FY2021 ขึ้นไป) มี 494,356 บรรทัด ผ่าน 489,157 (98.95%) และถูกซ่อน 5,199 บรรทัด รายละเอียดรายโดเมนอยู่ใน บันทึกการรื้อ V1 เป็น V2
ไฟล์สแกนล่ะ? ทดสอบกับเอกสารผิดก่อนเชื่อ
ไฟล์ที่เป็นภาพสแกนล้วนไม่มีพิกัดของตัวอักษร ด่านจึงพิสูจน์ไม่ได้และซ่อนทุกบรรทัดจากไฟล์นั้น ทางแก้คือ OCR ที่คืน กรอบของแต่ละคำ — ข้อความจาก OCR อาจไม่สวย แต่เราไม่ได้ต้องการข้อความจากมัน เราต้องการแค่พิกัด เพราะข้อความที่เชื่อถือได้อยู่ในข้อค้นพบแล้ว
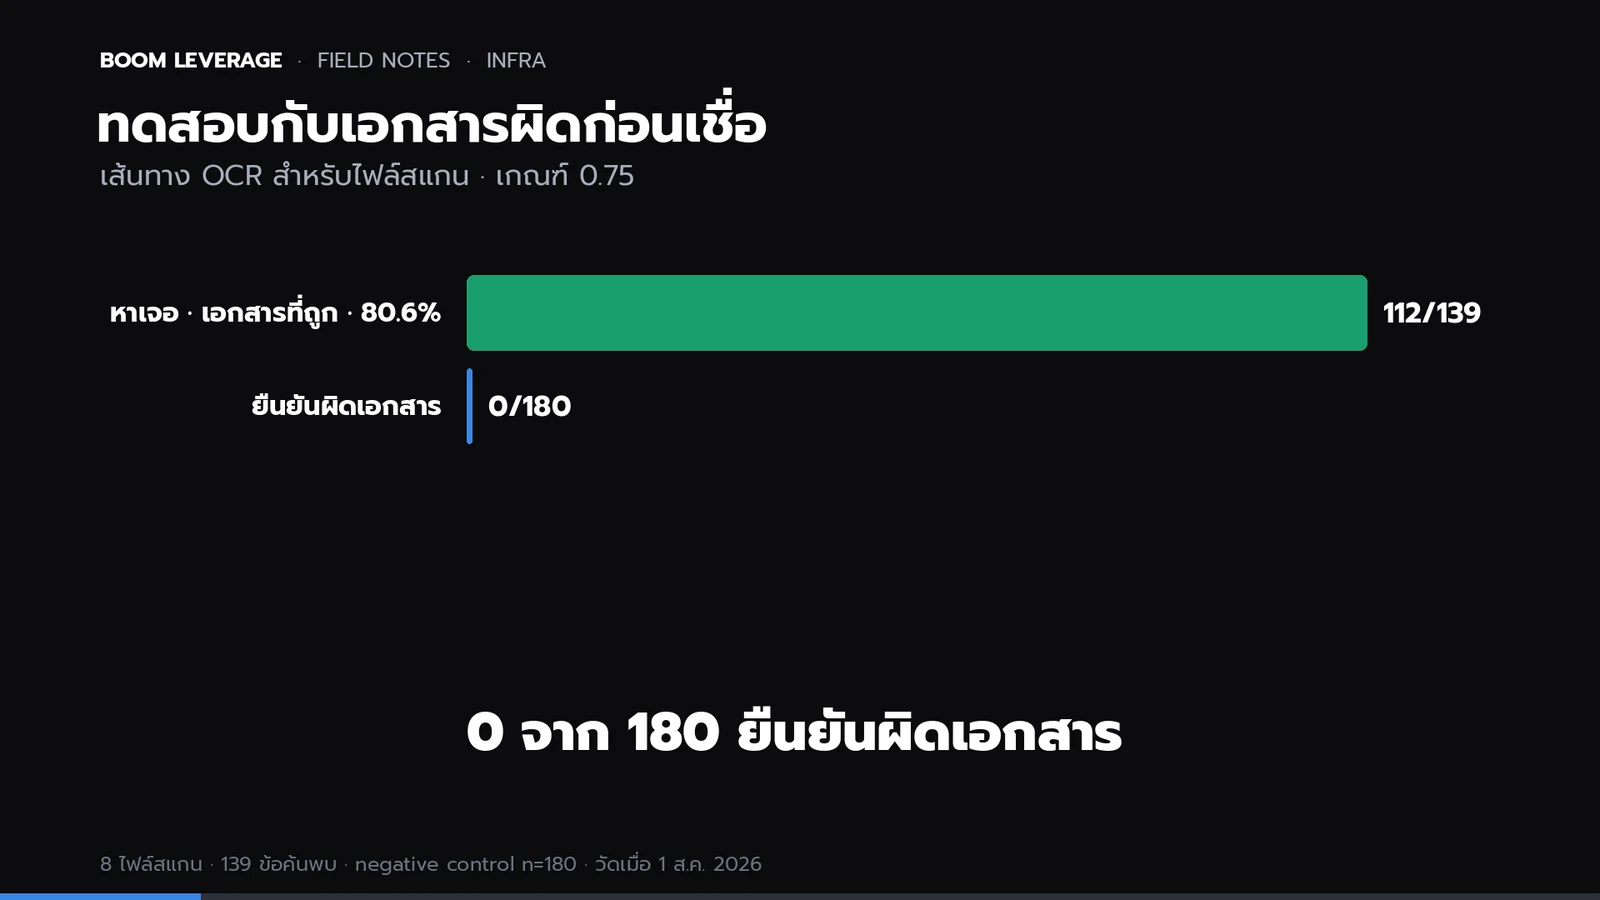
ก่อนสร้างจริง (1 ส.ค. 2026) มีการวัดสองแบบ:
| การทดสอบ | ผล |
|---|---|
| หาตำแหน่งเจอในเอกสารที่ถูก | 112 จาก 139 (80.6%) |
| ยืนยันผิดเอกสาร (negative control, n=180) | 0 จาก 180 ที่เกณฑ์ 0.75 |
| คะแนนสูงสุดกับเอกสารผิด (OCR) | 0.641 — ต่ำกว่าเกณฑ์ |
| คะแนนสูงสุดกับเอกสารผิด (เส้นทางข้อความปกติ) | 0.708 — ต่ำกว่าเกณฑ์เช่นกัน |
ข้อสรุปไม่ใช่ "OCR แม่น" แต่คือ "OCR แม่นพอที่จะบอกได้ชัดว่าเป็นเอกสารที่ถูก" ซึ่งเป็นคำอ้างเดียวที่ด่านต้องการ และการทดสอบกับเอกสารผิด (negative control) คือส่วนที่คนมักข้าม — ระบบที่ "หาเจอ" ทุกอย่างอาจแค่ยืนยันทุกอย่างมั่วๆ
อีกข้อที่ตั้งใจ: กรอบคำจาก OCR ถูกเก็บเป็นไฟล์แยกข้าง PDF ไม่เคยเขียนลงไฟล์ต้นฉบับ เพราะเอกสารคือหลักฐาน การแก้หลักฐานเพื่อให้เครื่องมือเราใช้ง่ายขึ้น จะทำลายสิ่งที่เรากำลังขายอยู่พอดี
ถ้าจะทำ RAG กับเอกสารการเงินเอง ควรเริ่มจากอะไร?
- แสดงต้นฉบับ อย่าแสดงคำเรียบเรียง — ถ้าต้องสรุป ให้วางสรุปคู่กับประโยคต้นฉบับและเลขหน้าเสมอ
- นิยาม "พิสูจน์ได้" ให้เครื่องตรวจได้ — เช่น ประโยคต้องหาเจอใน PDF ด้วยตัวจับคู่ที่กำหนด ไม่ใช่ให้โมเดลตัดสินเองว่า "ตรง"
- ตัดสินใจล่วงหน้าว่าสิ่งที่พิสูจน์ไม่ได้จะทำยังไง — ซ่อน หรือติดป้าย (Terminal เลือกซ่อน)
- วัดกับเอกสารผิดก่อนเชื่อทุกวิธีตรวจใหม่
- รายงานตัวเลขที่ถูกซ่อน ไม่ใช่แค่ตัวเลขที่ผ่าน
สรุป
RAG ที่ใช้กับเงินได้จริงไม่ได้วัดกันที่ "ค้นเจอแค่ไหน" แต่วัดที่ "ทุกบรรทัดที่แสดง พิสูจน์ได้ไหมว่ามาจากไหน" และยอมซ่อนสิ่งที่พิสูจน์ไม่ได้ แม้จะทำให้ผลค้นดูน้อยลง นี่คือหลักเดียวกับที่ผมใช้ตอนตรวจโมเดลในแบงก์ และเป็นเหตุผลที่ด่านทั้งหมดนี้อยู่ที่ชั้น harness ไม่ใช่ที่ตัวโมเดล
ฝั่งคนอ่าน: วิธีอ่าน 56-1, MD&A และรายงานผู้สอบบัญชีด้วยตัวเองอยู่ใน Filing Decoder Practice Lab
คำถามที่พบบ่อย
- ทำไมถาม AI หรือ LLM ตรงๆ กับงบการเงินหรือแบบ 56-1 ถึงเสี่ยง
- เพราะ LLM ตอบจากสิ่งที่จำได้ตอนฝึก ไม่ใช่จากไฟล์ที่เราถือ ถ้าเอกสารยาวเกินหรือจำคลาดเคลื่อน มันมักเดาให้เนียนแทนที่จะบอกว่าไม่รู้ ในงานการเงินคำตอบที่ผิดแบบมั่นใจอันตรายกว่าคำว่าไม่พบในเอกสารเสมอ
- RAG กับเอกสารการเงินทำงานอย่างไรใน Boom Leverage Terminal
- RAG คือการค้นข้อความจริงจากเอกสารก่อนแล้วตอบจากข้อความนั้นเท่านั้น ใน Terminal ระบบสกัดแบบ 56-1 และ MD&A เป็นข้อค้นพบ แปลงเป็นเวกเตอร์ 384 มิติด้วยโมเดล multilingual MiniLM ค้นตามความหมายพร้อม floor คะแนน แล้วผ่านด่าน citation ก่อนแสดงข้อความต้นฉบับพร้อมเลขหน้า
- ด่าน citation คืออะไร และถ้าพิสูจน์ไม่ได้จะเกิดอะไรขึ้น
- ด่าน citation คือขั้นที่เปิด PDF ต้นฉบับแล้วหาประโยคของข้อค้นพบนั้นให้เจอด้วยตัวจับคู่ตัวเดียวกับไฮไลต์บนหน้าจอ หาไม่เจอคือซ่อน ไม่ใช่ติดป้าย และประโยคที่เกือบตรงจะถูกให้คะแนนแต่ยังถูกซ่อน ณ 27 ก.ย. 2026 ผ่าน 98.95% ของ 494,356 บรรทัดใน 5 โดเมนที่เปิดเผยแพร่
- ไฟล์ PDF ที่เป็นภาพสแกนตรวจ citation อย่างไร
- ใช้ OCR ที่คืนกรอบของแต่ละคำเพื่อเอาพิกัด ไม่ได้เอาข้อความจาก OCR และเก็บกรอบคำเป็นไฟล์แยก ไม่เขียนลงไฟล์ต้นฉบับ ผลทดสอบวันที่ 1 ส.ค. 2026 หาตำแหน่งเจอ 112 จาก 139 หรือ 80.6% และยืนยันผิดเอกสาร 0 จาก 180 ที่เกณฑ์ 0.75
- negative control คืออะไร และทำไมต้องทดสอบกับเอกสารผิดก่อนเชื่อวิธีตรวจใหม่
- negative control คือการเอาข้อความไปจับคู่กับเอกสารของบริษัทอื่นเพื่อดูว่าระบบยืนยันผิดหรือไม่ เพราะระบบที่หาเจอทุกอย่างอาจแค่ยืนยันทุกอย่างมั่วๆ ในการทดสอบนี้คะแนนสูงสุดกับเอกสารผิดอยู่ต่ำกว่าเกณฑ์ทั้งเส้นทาง OCR และเส้นทางข้อความปกติ