ทดลองก่อนแก้: กฎที่ทำให้ AI agent ปรับระบบ Terminal โดยไม่ต้องเดา (และไม่เผาเงิน)
ตอนสร้าง Boom Leverage Terminal ผมห้ามทั้งตัวเองและ AI agent แก้ระบบจริงตามความรู้สึก ทุกการเปลี่ยนแปลงต้องผ่านการทดลองที่ทำซ้ำได้ก่อน นี่คือโปรโตคอล 5 ส่วนที่ใช้จริง ตัวเลขจาก lab log และ 2 เคสที่การทดลองพลิกความเชื่อตั้งต้น
โดย วรัญชัย ยิ่งคำนึง (Boom) · เผยแพร่ครั้งแรก · ตรวจทานล่าสุด
ตอนสร้าง Boom Leverage Terminal ด้วย AI agent ผมเจอกับดักเดิมซ้ำๆ: ระบบช้าหรือผลแปลก แล้วทั้งผมและ agent ก็อยากลงมือแก้ทันทีตามสิ่งที่ "น่าจะใช่" นิสัยนี้ดูขยัน แต่ในงานที่มีลูกค้าใช้จริง มันคือการเดิมพันด้วยระบบ production
พื้นหลังของผมคืองาน model validation ในธนาคาร ที่นั่นไม่มีใครเปลี่ยนโมเดลเพราะ "รู้สึกว่าดีขึ้น" ต้องมีหลักฐานที่คนอื่นทำซ้ำได้ ผมเอาวินัยเดียวกันมาใส่ใน harness ของ agent (ถ้ายังไม่คุ้นคำนี้ อ่าน Harness คืออะไร ก่อน)
ทำไม "แก้เลย" ถึงแพงกว่าที่คิด?
เพราะต้นทุนจริงไม่ได้อยู่ที่การแก้ แต่อยู่ที่ การแก้ผิดจุด ซึ่งมาพร้อม 3 อย่าง:
- เวลาที่เสียไปกับตัวแปรที่ไม่ใช่ต้นเหตุ — แก้แล้วดูดีขึ้นนิดหน่อยเพราะ noise แล้วก็เชื่อว่าแก้ถูก
- ความเสี่ยงต่อระบบที่ลูกค้าใช้อยู่ — ทุกการแก้ใน production คือโอกาสพังใหม่
- เงิน — ถ้าการแก้เกี่ยวกับ LLM ที่คิดเงินต่อ token การลองผิดลองถูกบนโมเดลแพงคือการเผาเงินตรงๆ
AI agent ทำให้ปัญหานี้หนักขึ้น เพราะมันแก้โค้ดได้เร็วมาก ความเร็วที่ไม่มีวินัยกำกับ = ความผิดพลาดที่มาถึงเร็วขึ้น
กฎเดียวที่มาก่อนทุกอย่างคืออะไร?
เขียนโปรโตคอลก่อน แล้วค่อยแตะระบบ ในไฟล์กฎหลักที่ agent ต้องโหลดทุก session เขียนไว้ว่า:
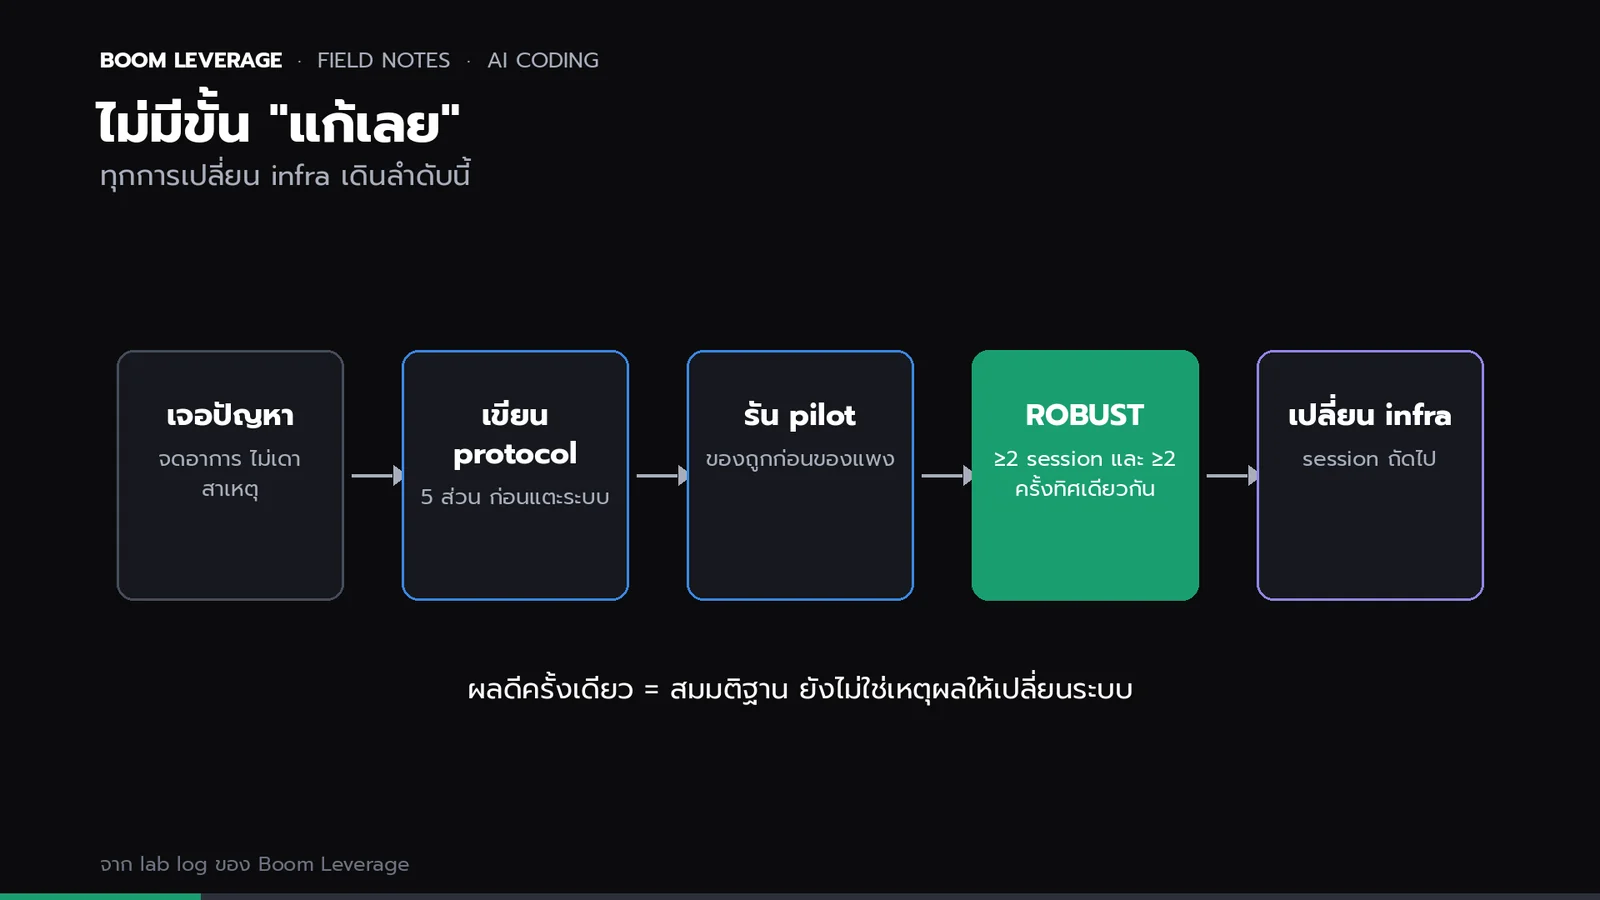
เจอปัญหา → ออกแบบ experiment → รัน → เสนอเปลี่ยน session ถัดไป. design ไม่ได้ → ดู log → ขอ deep research จาก Boom.
สังเกตคำว่า "เสนอเปลี่ยน session ถัดไป" — แม้การทดลองจะออกมาดี ก็ยังไม่เปลี่ยนทันทีใน session เดียวกัน เพราะคนที่เพิ่งรันการทดลองมักมองผลตัวเองดีเกินจริง การเว้นระยะหนึ่งรอบบังคับให้มีการมองซ้ำ
โปรโตคอล 5 ส่วนหน้าตาเป็นยังไง?
ก่อนรันอะไร ต้องตอบ 5 ข้อนี้ให้ครบ ถ้าตอบไม่ได้ แปลว่ายังไม่พร้อมทดลอง:
| ส่วน | ต้องตอบว่า | ถ้าข้าม จะเจออะไร |
|---|---|---|
| คำถาม / สมมติฐาน | เปลี่ยนอะไร คาดว่าตัวเลขไหนดีขึ้น เพราะอะไร | ทดลองเสร็จแล้วไม่รู้ว่าผลนี้ "ดี" หรือเปล่า |
| วิธีวัด | ใช้ harness ไหน เทียบกับเฉลยอะไร metric ไหนตัดสิน | ตัวเลขที่ได้เทียบกับอะไรไม่ได้ |
| สิ่งที่เทส | ครบทุก backend ที่ระบบใช้จริง ไม่ใช่ตัวเดียว | ผลดีบนตัวหนึ่ง แต่พังบนตัวที่ใช้จริง |
| งบประมาณ | จำนวนตัวอย่างและเพดานเงิน พร้อมเหตุผล | รันจนเงินหมดโดยไม่มีจุดหยุด |
| confound ที่รู้ล่วงหน้า | output ถูกตัด? เวอร์ชันโมเดลไม่คงที่? ตัวอย่างน้อยไป? | ต้องรันซ้ำเพราะปัญหาที่เดาได้ตั้งแต่แรก |
ทุกการทดลองเก็บไว้ในโฟลเดอร์เดียวที่มีโครงตายตัว — protocol, โค้ดที่ใช้รัน, คำสั่งที่รันแบบคำต่อคำ, ผลดิบ ทุก call และสรุปการตัดสินใจ ส่วนที่คนมักทิ้งคือผลดิบ ซึ่งเป็นส่วนที่ประหยัดเงินที่สุด เพราะอยากวิเคราะห์ใหม่เมื่อไหร่ก็อ่านไฟล์ได้เลย ไม่ต้องยิง API ซ้ำ
ทำไม pilot ผ่านแล้วยังไม่พอ?
นี่คือเคสจริงที่อธิบายได้ดีที่สุด ระบบ Terminal ถอดเสียงคลิป Opportunity Day (งานที่บริษัทจดทะเบียนตอบคำถามนักวิเคราะห์) เป็นข้อความ แต่ตัวถอดเสียงมักได้ยินตัวเลขผิด ผมเลยทดลองใช้ speech-to-text อีกตัวช่วย "กู้" ตัวเลขที่พลาด โดยตั้งเกณฑ์ไว้ก่อนรันว่า ต้องกู้ได้อย่างน้อย 20% ถึงจะคุ้มเปิดใช้
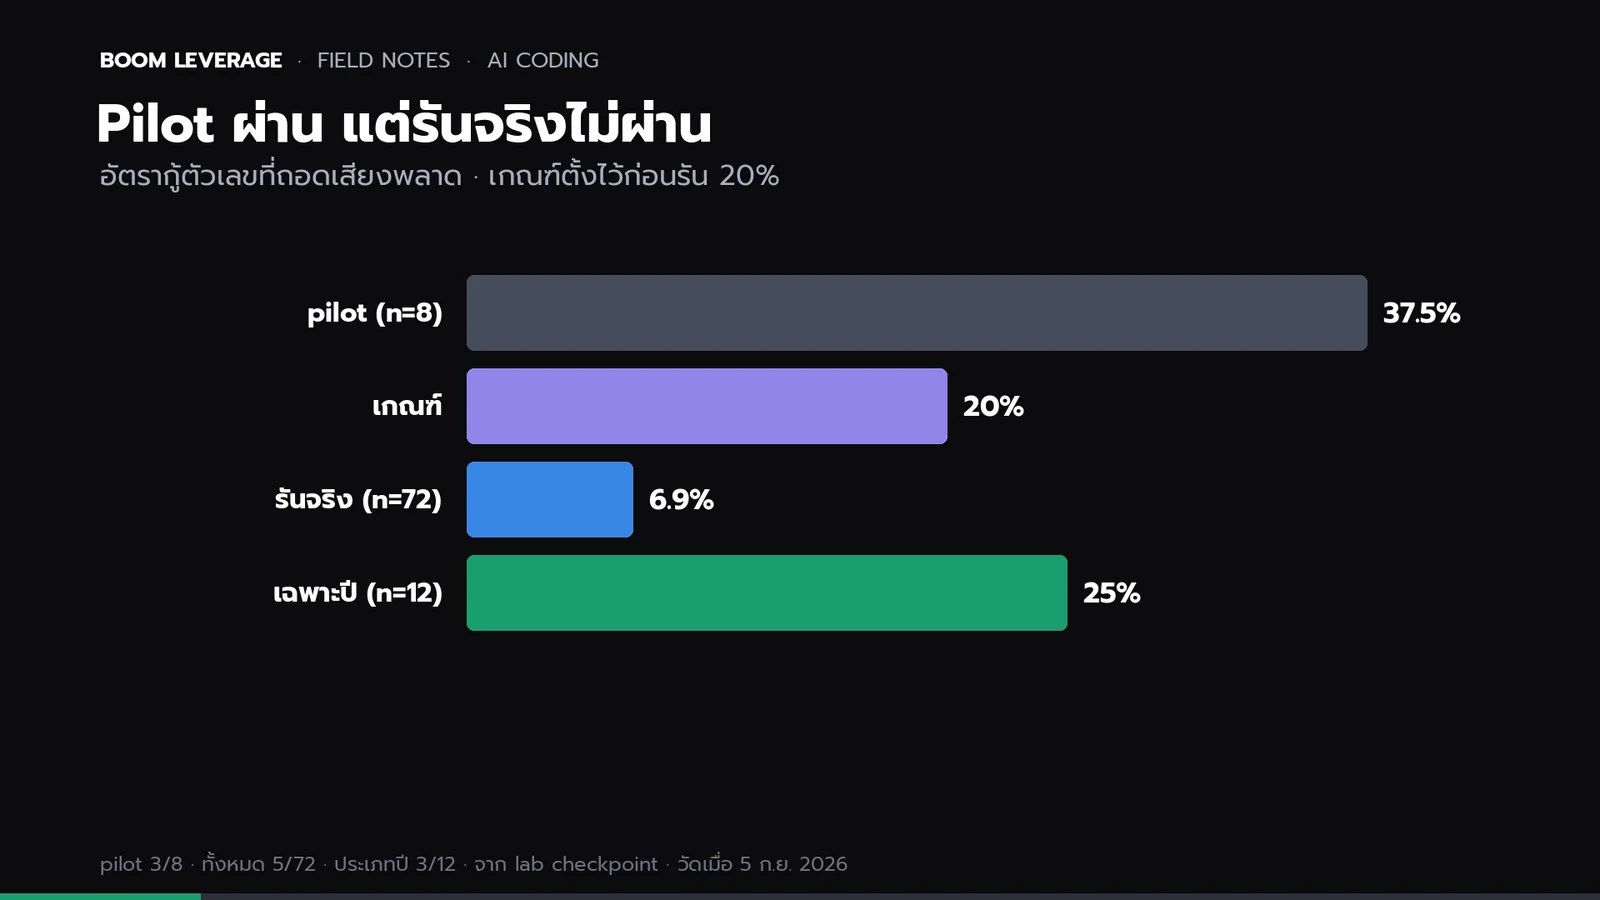
| รอบ | จุดที่ตัดสิน | กู้ได้ | อัตรา | ผลต่อเกณฑ์ 20% |
|---|---|---|---|---|
| pilot | 8 | 3 | 37.5% | ผ่าน |
| รันจริงรอบแรก (ทุกประเภท) | 72 | 5 | 6.9% | ไม่ผ่าน |
| เฉพาะตัวเลขประเภท "ปี" | 12 | 3 | 25% | ผ่าน |
ถ้าเราเชื่อ pilot ที่ n = 8 ระบบจะถูกเปิดใช้กับทุกคลิป ทั้งที่ผลจริงต่ำกว่าเกณฑ์เกือบ 3 เท่า สิ่งที่ได้จากการทดลองรอบจริงไม่ใช่แค่ "ไม่ผ่าน" แต่คือคำตอบที่แม่นกว่า: ใช้เฉพาะตัวเลขประเภทปีเท่านั้น (ซึ่งยังต้องเก็บตัวอย่างเพิ่ม เพราะ n = 12 ยังน้อย)
นี่คือเหตุผลที่เกณฑ์ ROBUST ต้องการผลทิศเดียวกัน อย่างน้อย 2 ครั้ง ครั้งเดียว — โดยเฉพาะครั้งที่ตัวอย่างน้อย — ยังเป็นแค่สมมติฐาน
การทดลองเคยพลิกสิ่งที่ผมมั่นใจไหม?
เคย และบ่อยกว่าที่อยากยอมรับ ตัวอย่างหนึ่งคือตอนหน้าเว็บหลักโหลดช้า (LCP เกิน 2.5 วินาที) ผมมั่นใจว่าตัวต้นเหตุคือไฟล์วิดีโอพื้นหลังที่แย่ง bandwidth แผนแรกจึงจัดให้การแก้วิดีโอเป็นอันดับหนึ่ง ก่อนลงมือ แผนถูกส่งเข้าด่านตรวจแบบ adversarial ซึ่งเรียกร้องหลักฐาน แล้วการทดลองแบบแยกตัวแปรให้ผลนี้:
the isolation experiment (block-one-suspect, 3 reps each, medians) confirmed contention is real but showed Mux is NOT the lever.
แปลตรงๆ คือ ปิดผู้ต้องสงสัยทีละตัว รันตัวละ 3 รอบ ดูค่ามัธยฐาน แล้วพบว่าการแย่ง bandwidth มีจริง แต่วิดีโอ ไม่ใช่ จุดที่แก้แล้วได้ผล ถ้าผมแก้ตามความมั่นใจ จะได้งานที่เหนื่อยแต่ไม่ขยับตัวเลข
แล้วเมื่อไหร่ถึงจะยอมเปลี่ยนระบบจริง?
เมื่อผ่านเกณฑ์ ROBUST ซึ่งเขียนไว้ในกฎหลักว่า:
ใช้ซ้ำ ≥2 sessions AND ≥2 lab PASS ทิศเดียวกัน (= ROBUST)
และยังมีข้อยกเว้นที่ไม่ต้องรอ คือการจัดเอกสารและย้ายไฟล์เข้าถังพัก ซึ่งย้อนกลับได้ง่าย ส่วนอะไรที่แตะพฤติกรรมของระบบ ต้องผ่านเกณฑ์นี้ก่อนเสมอ
| สถานะในคลัง lab (26 ก.ย. 2026) | จำนวน |
|---|---|
| การทดลองที่ออกแบบไว้ทั้งหมด | 313 |
| รันจบแล้ว | 119 |
| อยู่ในคิวรอรัน | 9 |
ตัวเลขนี้ไม่ได้บอกว่าผมทดลองเยอะ มันบอกว่า ไอเดียส่วนใหญ่ไม่ได้ถูกรันเลย — เพราะการเขียนโปรโตคอลบังคับให้ถามว่า "คุ้มไหม" ก่อนเสียเงินจริง และหลายไอเดียตกตั้งแต่ขั้นนั้น
สรุป
ความเร็วของ AI agent เป็นข้อดีก็ต่อเมื่อมีวินัยกำกับ กฎ "ทดลองก่อนแก้" ไม่ได้ทำให้ช้าลง มันทำให้ แก้ถูกจุดตั้งแต่ครั้งแรก บ่อยขึ้น: เขียนโปรโตคอล 5 ส่วน, รัน pilot ก่อนของแพง, อย่าเชื่อผลครั้งเดียว และเปลี่ยนระบบจริงเมื่อผ่าน ROBUST
สำหรับคนสร้าง product การเงิน นี่คือวินัยเดียวกับที่ธนาคารใช้ validate โมเดล แค่ย้ายมาอยู่ใน harness ของ agent (ดูตัวอย่างอื่นของ harness ใน ทำไมผมสร้าง Terminal ด้วย Claude Code)
คำถามที่พบบ่อย
- กฎทดลองก่อนแก้ (experiment before change) สำหรับ AI agent คืออะไร
- คือกฎในไฟล์กฎหลักของ lab ที่เขียนว่า เจอปัญหา ออกแบบ experiment รัน แล้วเสนอเปลี่ยนใน session ถัดไป โดยไม่มีขั้นแก้เลย แม้ผลทดลองออกมาดีก็ยังไม่เปลี่ยนใน session เดียวกัน เพราะคนที่เพิ่งรันการทดลองมักมองผลตัวเองดีเกินจริง
- โปรโตคอลการทดลองก่อนแก้ระบบต้องมีอะไรบ้าง
- ต้องตอบให้ครบ 5 ส่วนก่อนรัน คือคำถามและสมมติฐาน วิธีวัดที่เทียบกับเฉลยและ metric ที่ใช้ตัดสิน สิ่งที่เทสให้ครบทุก backend ที่ใช้จริง งบประมาณคือจำนวนตัวอย่างและเพดานเงิน และ confound ที่รู้ล่วงหน้า ถ้าตอบไม่ได้แปลว่ายังไม่พร้อมทดลอง
- เกณฑ์ ROBUST คืออะไร และเมื่อไหร่ถึงเปลี่ยน infra จริง
- เกณฑ์ ROBUST คือต้องใช้ซ้ำอย่างน้อย 2 session และผ่านการทดลองอย่างน้อย 2 ครั้งในทิศเดียวกัน โครงสร้างพื้นฐานจะเปลี่ยนจริงเมื่อผ่านเกณฑ์นี้เท่านั้น ข้อยกเว้นคือการจัดเอกสารและย้ายไฟล์เข้าถังพักซึ่งย้อนกลับได้ง่าย
- ทำไมผล pilot ที่ผ่านเกณฑ์แล้วยังเชื่อไม่ได้
- เพราะตัวอย่างน้อยอาจหลอกได้ ในเคสกู้ตัวเลขที่ถอดเสียงพลาดจากคลิป Opportunity Day ตัว pilot ที่ n เท่ากับ 8 กู้ได้ 37.5% ผ่านเกณฑ์ 20% แต่รันจริง 72 จุดเหลือ 6.9% ไม่ผ่าน ผลที่ได้คือใช้เฉพาะตัวเลขประเภทปีซึ่งได้ 25% และยังต้องเก็บตัวอย่างเพิ่ม
- การทดลองแบบแยกตัวแปร (isolation experiment) ช่วยหาต้นเหตุเว็บโหลดช้าได้อย่างไร
- วิธีคือปิดผู้ต้องสงสัยทีละตัว รันตัวละ 3 รอบแล้วดูค่ามัธยฐาน ในเคสหน้าเว็บที่ LCP เกิน 2.5 วินาที ผลยืนยันว่ามีการแย่ง bandwidth จริง แต่ไฟล์วิดีโอพื้นหลังที่มั่นใจว่าเป็นต้นเหตุไม่ใช่จุดที่แก้แล้วได้ผล