คุมค่า LLM ตอนรัน product: เลือกรุ่นให้ถูกงาน วาง router และปล่อยให้ cache ทำงาน
ค่า LLM ไม่ได้บานเพราะโมเดลแพง แต่บานเพราะส่งทุกงานเข้าโมเดลแพงสุด นี่คือวิธีที่ใช้จริงตอนสร้าง Boom Leverage Terminal: ราคาต่อรุ่นที่ตรวจวันนี้, router ที่ส่งงานตามความลับและขนาด, บันได fallback ที่เดินครั้งเดียว และตัวเลข cache 98% ที่เปลี่ยนต้นทุนทั้งสมการ
โดย วรัญชัย ยิ่งคำนึง (Boom) · เผยแพร่ครั้งแรก · ตรวจทานล่าสุด
ตอนเริ่มให้ AI agent ทำงานอัตโนมัติ สิ่งแรกที่คนมักเจอคือบิลค่า LLM ที่โตเร็วกว่าที่คิด สาเหตุแทบไม่เคยเป็น "โมเดลแพง" แต่เป็น การใช้โมเดลตัวเดียวกับทุกงาน — สรุปข้อความสั้นๆ ก็ใช้รุ่นใหญ่ จัดรูปแบบตารางก็ใช้รุ่นใหญ่ ทั้งที่งานเหล่านั้นรุ่นเล็กทำได้ดีพอกัน
ตอนสร้าง Boom Leverage Terminal ผมมองเรื่องนี้แบบคนทำ risk: ต้นทุนเป็นตัวแปรที่ออกแบบได้ ไม่ใช่สิ่งที่ต้องยอมรับ และการออกแบบนั้นอยู่ใน harness รอบโมเดล (อ่านต่อใน Harness คืออะไร)
รุ่นไหนราคาเท่าไหร่ในวันนี้?
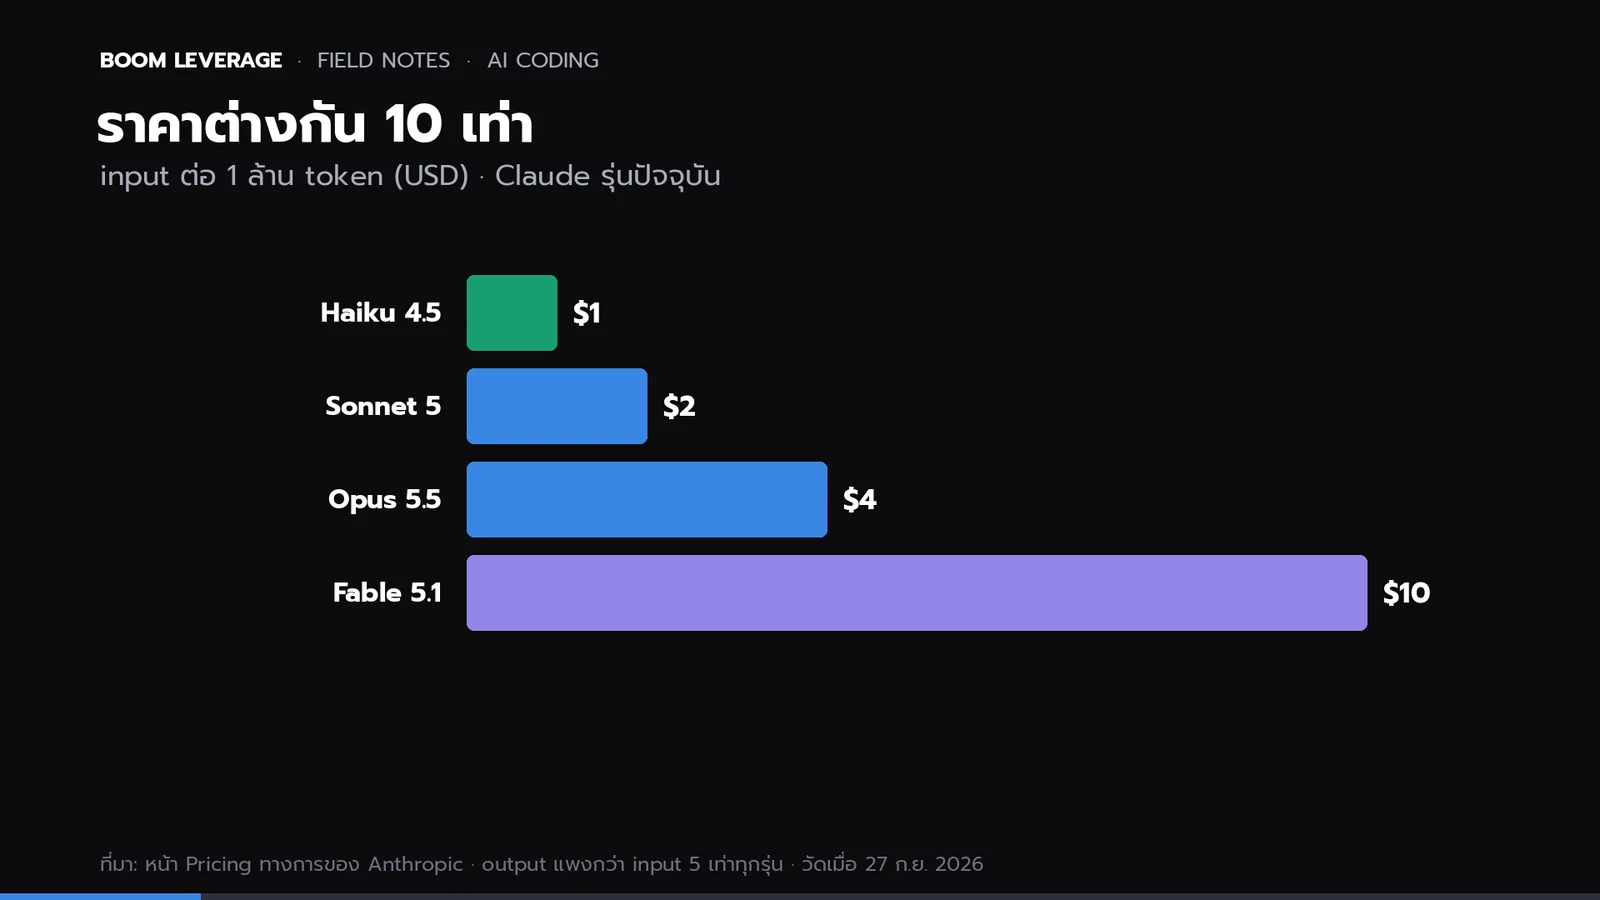
| รุ่น | input / ล้าน token | output / ล้าน token | อ่านจาก cache |
|---|---|---|---|
| Claude Haiku 4.5 | $1 | $5 | $0.10 (10%) |
| Claude Sonnet 5 | $2 | $10 | $0.20 (10%) |
| Claude Opus 5.5 | $4 | $20 | $0.20 (5%) |
| Claude Fable 5.1 | $10 | $50 | $0.25 (2.5%) |
ที่มา: หน้า Pricing ของ Anthropic ตรวจเมื่อ 27 ก.ย. 2026 (Sonnet 5 ราคา $2/$10 กลายเป็นราคามาตรฐานถาวรแล้ว ตามหมายเหตุในหน้าเดียวกัน)
สองข้อที่คนมักเข้าใจผิด:
- รุ่นแพงไม่ได้ดีกว่าเสมอสำหรับทุกงาน — งานจัดรูปแบบ แปลงข้อมูล หรือสรุปข้อความสั้น รุ่นเล็กให้ผลที่ใช้ได้เท่ากัน ส่วนต่างราคาคือเงินที่จ่ายทิ้ง
- Fable คือรุ่นพรีเมียม ไม่ใช่ตัวประหยัด — แพงที่สุดในตาราง แต่ค่าอ่าน cache ถูกที่สุดในเชิงสัดส่วน (2.5%) จึงคุ้มกับงานยาวที่ใช้บริบทเดิมซ้ำๆ ไม่ใช่งานสั้นจำนวนมาก
หลักที่ Anthropic เองแนะนำในหน้าเดียวกันก็ตรงกัน: Haiku สำหรับงานง่าย, Sonnet สำหรับงาน production ส่วนใหญ่, Opus สำหรับงานที่ต้องคิดซับซ้อนที่สุด
Router ของระบบตัดสินใจส่งงานไปไหน?
ระบบที่ใช้สร้าง Terminal ไม่ได้ให้ Claude ทำทุกอย่างเอง งานที่มีโครงชัด (ดึงข้อมูล จัดตาราง ร่างสรุป) ถูกส่งต่อให้ "โมเดลลูกน้อง" ที่ถูกกว่าหรือฟรี โดย Claude ทำหน้าที่วางแผน ตรวจผล และตัดสินใจสุดท้าย
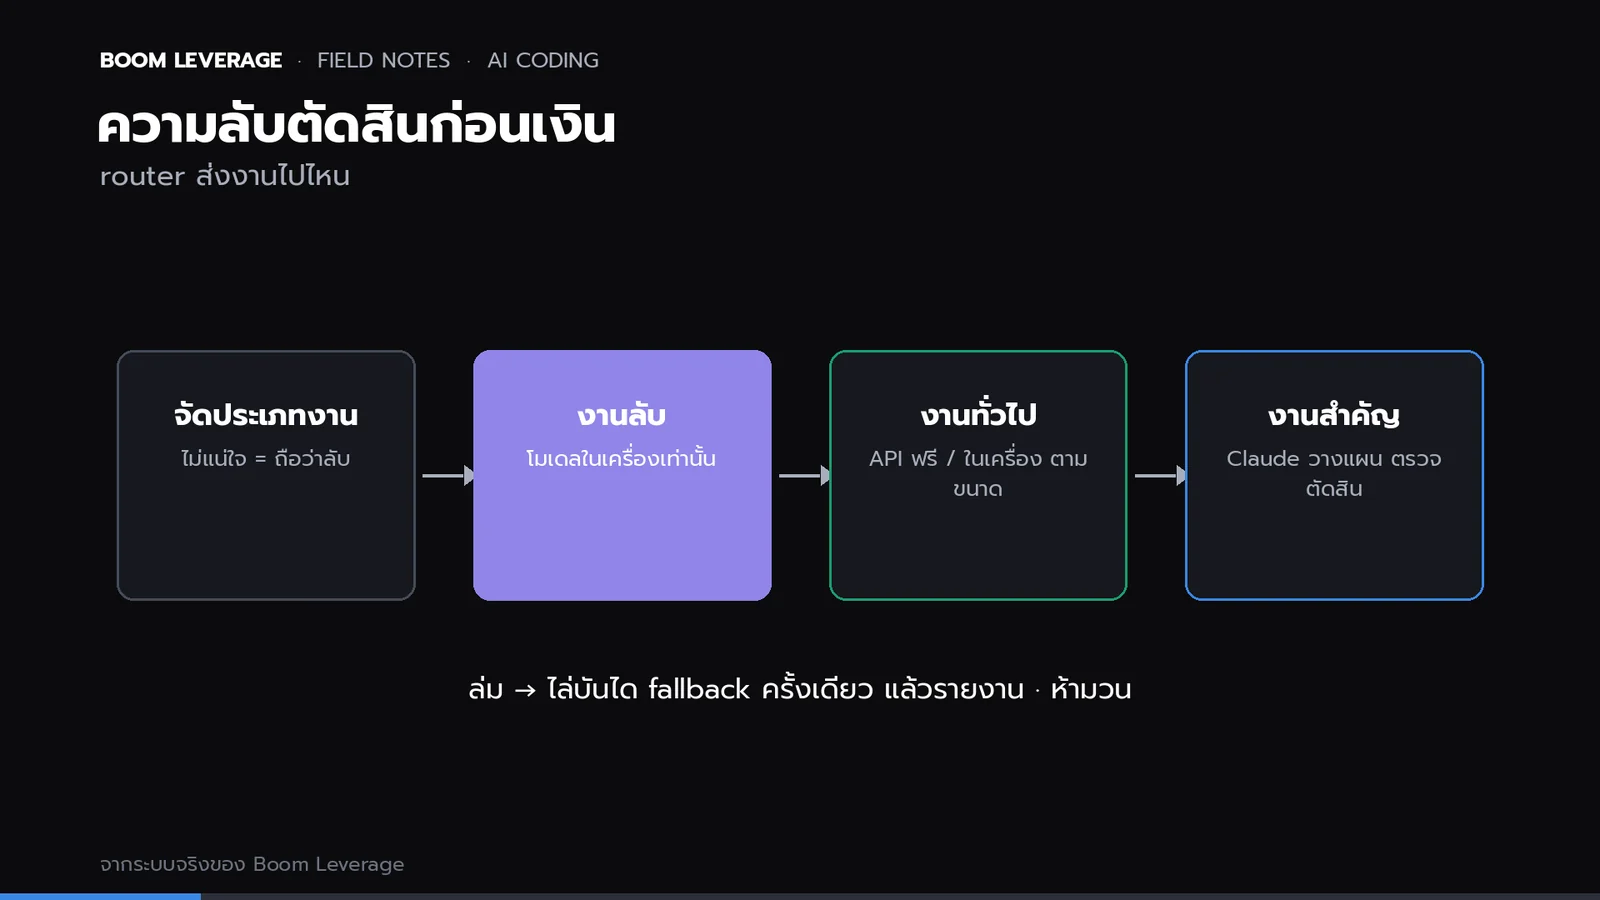
| ลำดับ | คำถาม | ถ้าใช่ ส่งไป |
|---|---|---|
| 1 | งานมีข้อมูลลับ / ข้อมูลส่วนบุคคลไหม? | โมเดลในเครื่องเท่านั้น (ไม่ออกนอกเครื่อง) |
| 2 | เป็นงานสำคัญ (แก้กฎ ตรวจโค้ดรอบสุดท้าย) ไหม? | Claude ทำเอง |
| 3 | งานทั่วไป ขนาดเท่าไหร่? | โมเดลเปิด Gemma 4 ผ่าน API ฟรี หรือโมเดลในเครื่อง ตามช่วงขนาดข้อมูล |
| 4 | ผลลูกน้องถูกเกิน 80% ไหม? | Claude แก้ส่วนที่เหลือเอง ไม่สั่งรันใหม่ (ประหยัด token) |
ข้อ 1 คือหัวใจ: ความลับตัดสินก่อนเงิน งานที่แตะข้อมูลอ่อนไหวจะไม่ถูกส่งออก cloud ไม่ว่าจะถูกกว่าแค่ไหน และถ้าไม่แน่ใจว่าลับหรือไม่ ระบบถือว่าลับไว้ก่อน
ถ้าโมเดลตัวหลักล่ม ระบบทำยังไง?
มีบันได fallback 5 ขั้น (ผู้ให้บริการสำรองคนละเจ้า → โมเดลที่ quota คนละก้อน → โมเดลในเครื่อง → Claude เป็นทางสุดท้าย) แต่มีกฎสองข้อที่สำคัญกว่าตัวบันได:
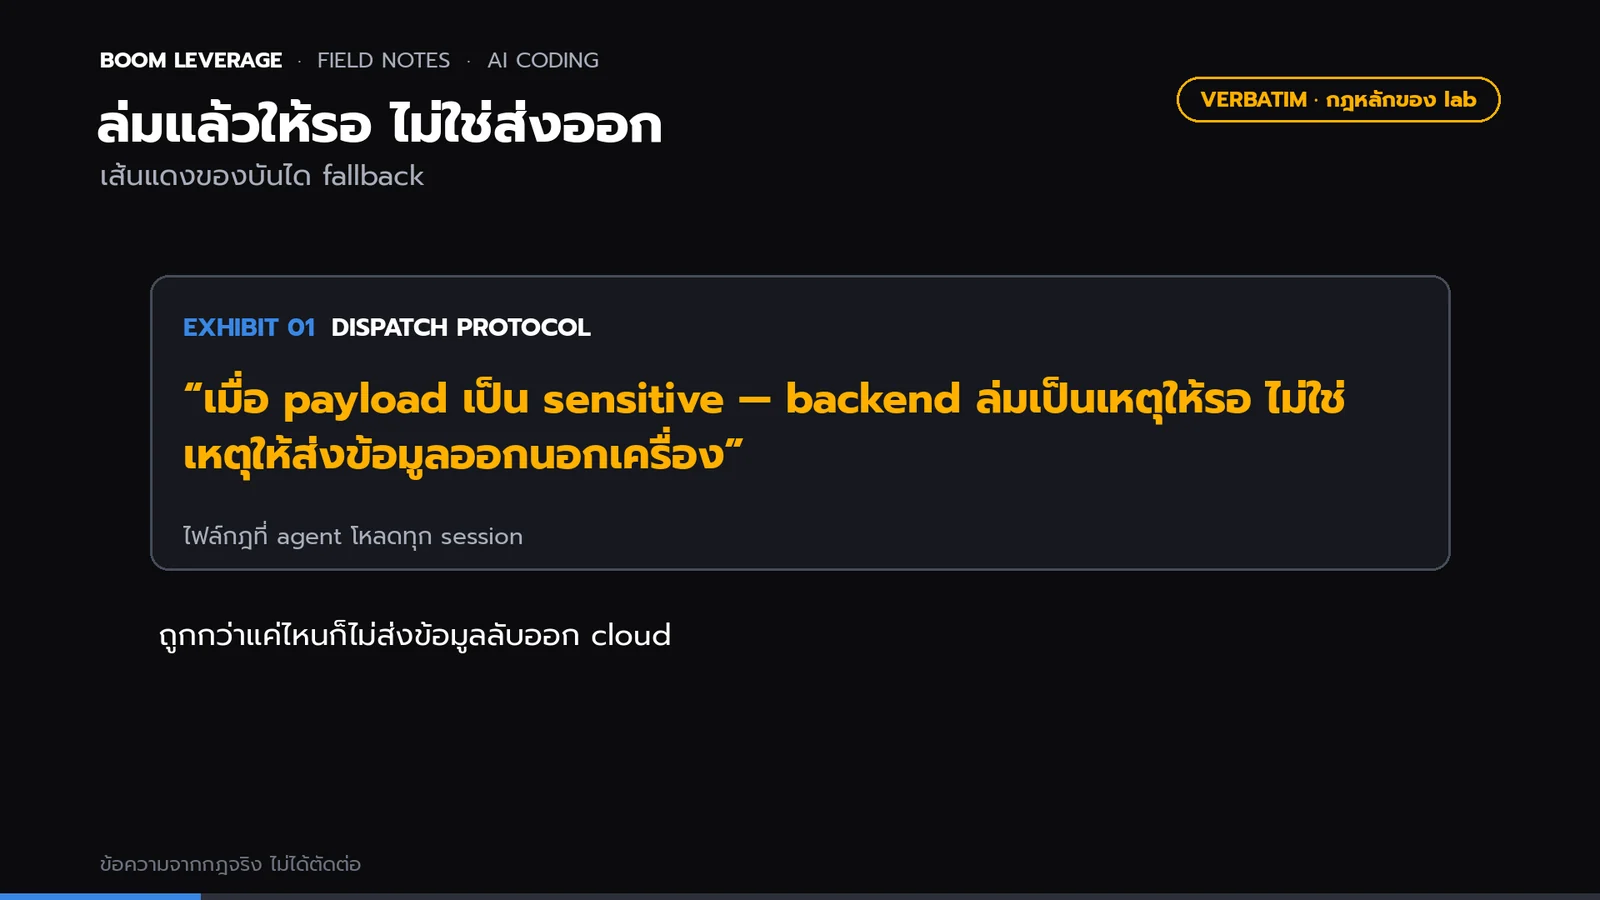
เมื่อ payload เป็น sensitive — backend ล่มเป็นเหตุให้ รอ ไม่ใช่เหตุให้ส่งข้อมูลออกนอกเครื่อง
และ บันไดเดินครั้งเดียว จบแล้วจบเลย ห้าม retry วน เพราะผู้ให้บริการสองขั้นแรกบางครั้งเป็นบริษัทเดียวกัน ถ้าล่มทั้งบ้าน การวนใหม่จะค้างเงียบและเผาเวลา ลงครบทุกขั้นแล้วยังไม่ได้ = รายงานคน ทุกครั้งที่ตกลงบันไดยังต้อง log ไว้ด้วย เพราะ fallback ที่เงียบ = เราจะไม่มีวันรู้ว่าตัวหลักเสีย
ใช้งานจริงไปเท่าไหร่ และเสียเงินเท่าไหร่?
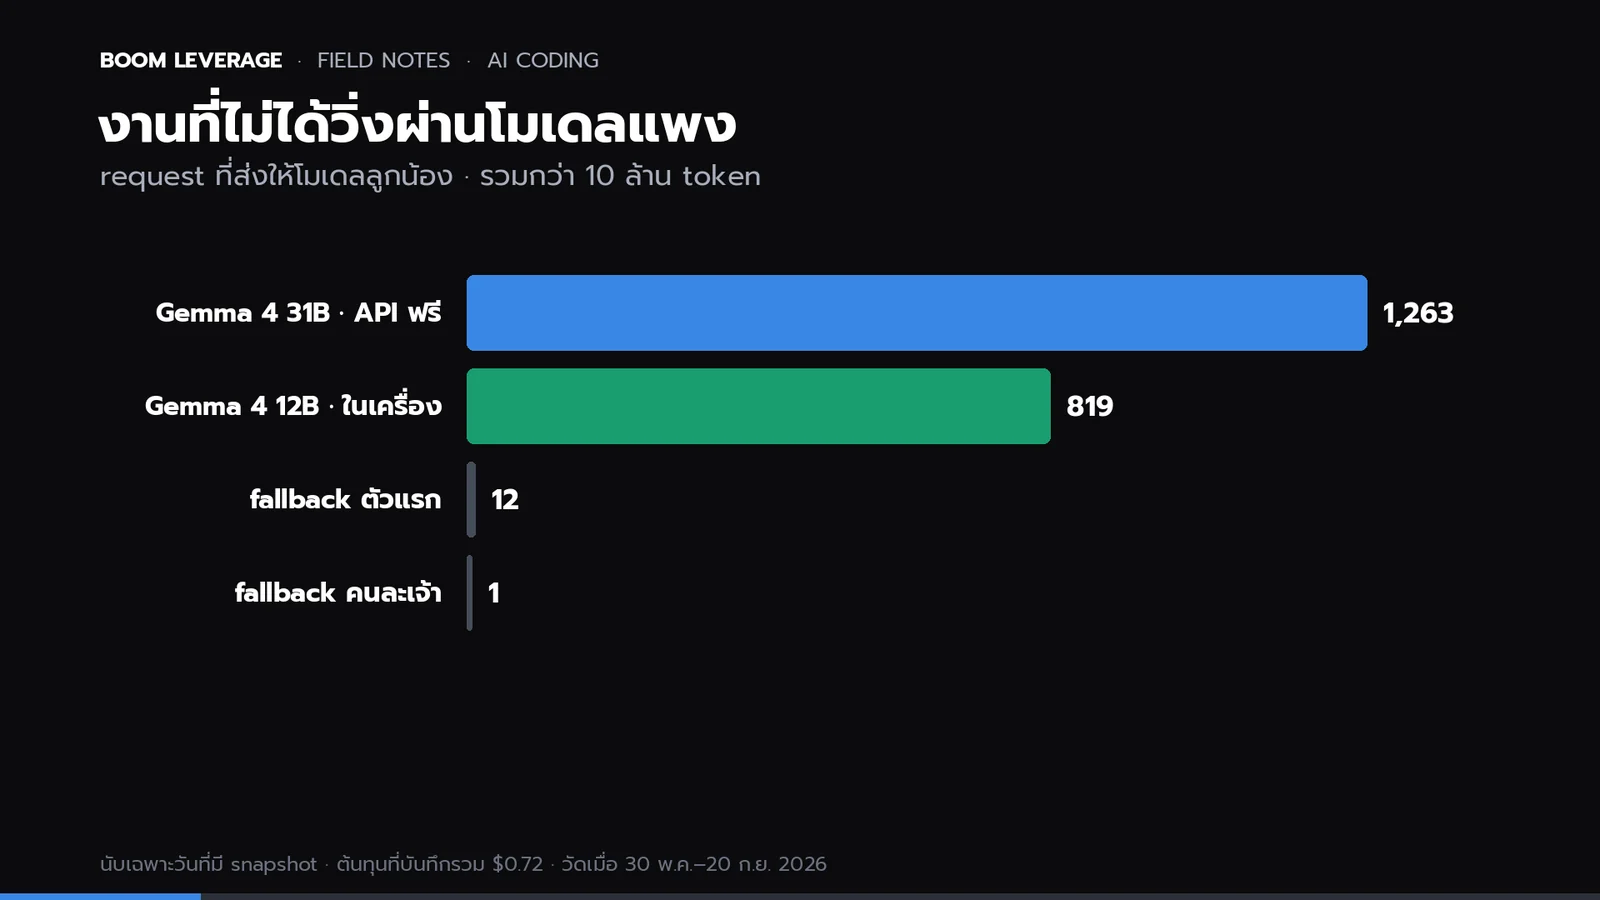
| backend | request | token รวม | ช่วงที่บันทึก |
|---|---|---|---|
| Gemma 4 31B ผ่าน API ฟรี | 1,263 | 3,938,132 | 32 วัน (30 พ.ค. – 20 ก.ย.) |
| Gemma 4 12B ในเครื่อง | 819 | 6,109,352 | 16 วัน (30 พ.ค. – 2 ส.ค.) |
| fallback ตัวแรก (ผู้ให้บริการสำรอง) | 12 | 37,678 | 5 วัน |
| fallback คนละเจ้า | 1 | 10,978 | 1 วัน |
รวมกว่า 10 ล้าน token ที่ไม่ได้วิ่งผ่านโมเดลแพง ต้นทุนที่ระบบบันทึกไว้ทั้งช่วงรวมกัน $0.72 เพราะเกือบทั้งหมดอยู่ในโควตาฟรีหรือรันในเครื่อง (ตัวเลขนี้นับเฉพาะวันที่มี snapshot จึงเป็นค่าต่ำกว่าจริง ไม่ใช่ยอดครบ)
ทำไม cache ถึงสำคัญกว่าการเลือกรุ่น?
ตัวเลขที่เปลี่ยนมุมมองผมมากที่สุดคือ ใน 30 วันล่าสุด (ถึง 26 ก.ย. 2026) 98.2% ของ token ฝั่ง input ที่ Claude Code ใช้ เป็นการ อ่านจาก cache — บริบทเดิม (กฎ CLAUDE.md ไฟล์ที่เปิดไว้ ประวัติบทสนทนา) ที่ถูกส่งซ้ำทุกเทิร์น
ลองคิดด้วยราคาทางการของ Opus 5 ($5 ต่อล้าน token, อ่าน cache คิด 0.1 เท่า = $0.50):
| คำนวณ | ราคา input เฉลี่ย / ล้าน token | |
|---|---|---|
| ถ้าไม่มี cache เลย | 100% × $5 | $5.00 |
| cache 98.2% (ตัวเลขจริง) | 1.8% × $5 + 98.2% × $0.50 | ≈ $0.58 |
ถูกลงราว 8.6 เท่า ในฝั่ง input (ยังไม่นับค่าเขียน cache ครั้งแรกซึ่งแพงกว่าปกติ 1.25 เท่า) นี่หมายความว่าการออกแบบให้ บริบทนิ่งและถูกใช้ซ้ำ — กฎที่อยู่ไฟล์เดียว ไม่แก้ไปมาทุก session — มีผลต่อต้นทุนมากกว่าการสลับรุ่นไปมาเสียอีก
อีกข้อที่ได้คือ อย่าเชื่อรายงานต้นทุนที่นับ cache ผิด เครื่องมือวัดตัวแรกๆ ของผมคิดค่าอ่าน cache เท่าราคา input เต็ม ผลคือตัวเลขสูงเกินจริงหลายเท่า — ถ้าตัดสินใจตามตัวเลขนั้น จะไปตัดสิ่งที่ไม่ได้แพงจริง
สรุป
คุมค่า LLM ไม่ได้แปลว่าใช้โมเดลถูกที่สุด แต่แปลว่า จ่ายให้ตรงกับความยากของงาน: เลือกรุ่นตามงาน, ให้ router ส่งงานโดยเอาความลับเป็นกฎข้อแรก, เดินบันได fallback ครั้งเดียวแล้วรายงาน และออกแบบบริบทให้ cache ทำงาน ทั้งหมดนี้อยู่ใน harness ไม่ใช่ในตัวโมเดล (ดูเหตุผลเต็มใน ทำไมผมสร้าง Terminal ด้วย Claude Code)
คำถามที่พบบ่อย
- ทำไมค่า LLM ตอนรัน product ถึงบานเร็ว
- สาเหตุแทบไม่เคยเป็นเพราะโมเดลแพง แต่เป็นการใช้โมเดลตัวเดียวกับทุกงาน ทั้งที่งานจัดรูปแบบ แปลงข้อมูล หรือสรุปข้อความสั้น รุ่นเล็กให้ผลที่ใช้ได้เท่ากัน ตามราคาที่ตรวจเมื่อ 27 ก.ย. 2026 ราคา input ของ Claude รุ่นถูกสุดกับแพงสุดต่างกัน 10 เท่า
- ควรเลือกรุ่น Claude Haiku Sonnet Opus ให้เหมาะกับงานอย่างไร
- หลักที่ Anthropic แนะนำและบทความใช้คือ Haiku สำหรับงานง่าย Sonnet สำหรับงาน production ส่วนใหญ่ และ Opus สำหรับงานที่ต้องคิดซับซ้อนที่สุด ส่วน Fable เป็นรุ่นพรีเมียมที่ค่าอ่าน cache ถูกที่สุดในเชิงสัดส่วน จึงเหมาะกับงานยาวที่ใช้บริบทเดิมซ้ำ ไม่ใช่งานสั้นจำนวนมาก
- LLM router ควรตัดสินใจส่งงานไปโมเดลไหนอย่างไร
- router ของระบบถามเรื่องความลับก่อนเสมอ งานที่มีข้อมูลลับหรือข้อมูลส่วนบุคคลไปโมเดลในเครื่องเท่านั้น งานสำคัญอย่างแก้กฎหรือตรวจโค้ดรอบสุดท้าย Claude ทำเอง งานทั่วไปส่งให้ Gemma 4 ผ่าน API ฟรีหรือโมเดลในเครื่องตามขนาดงาน และถ้าไม่แน่ใจว่าลับหรือไม่ให้ถือว่าลับไว้ก่อน
- ถ้าโมเดลหลักล่ม ระบบ fallback ควรทำงานอย่างไร
- ระบบไล่บันได fallback 5 ขั้นครั้งเดียวแล้วจบ ห้าม retry วน ถ้าลงครบทุกขั้นแล้วยังไม่ได้ให้รายงานคน และต้อง log ทุกครั้งที่ตกบันได สำหรับงานลับ backend ล่มเป็นเหตุให้รอ ไม่ใช่เหตุให้ส่งข้อมูลออกนอกเครื่อง
- prompt cache ช่วยลดต้นทุน Claude Code ได้แค่ไหน
- ใน 30 วันถึง 26 ก.ย. 2026 ราว 98.2% ของ token ฝั่ง input ที่ Claude Code ใช้มาจากการอ่าน cache ซึ่งคิดราคาเพียงส่วนเล็กของราคาปกติ เมื่อคิดด้วยราคา Opus 5 ราคา input เฉลี่ยถูกลงราว 8.6 เท่า (ยังไม่นับค่าเขียน cache ครั้งแรก) การออกแบบให้บริบทนิ่งและถูกใช้ซ้ำจึงมีผลต่อต้นทุนมากกว่าการสลับรุ่นไปมา