Data Science สาย Credit Risk: จากสมมติฐานสู่โมเดลที่ใช้ได้จริง — และวินัยเดียวกันที่ใช้สร้าง Terminal
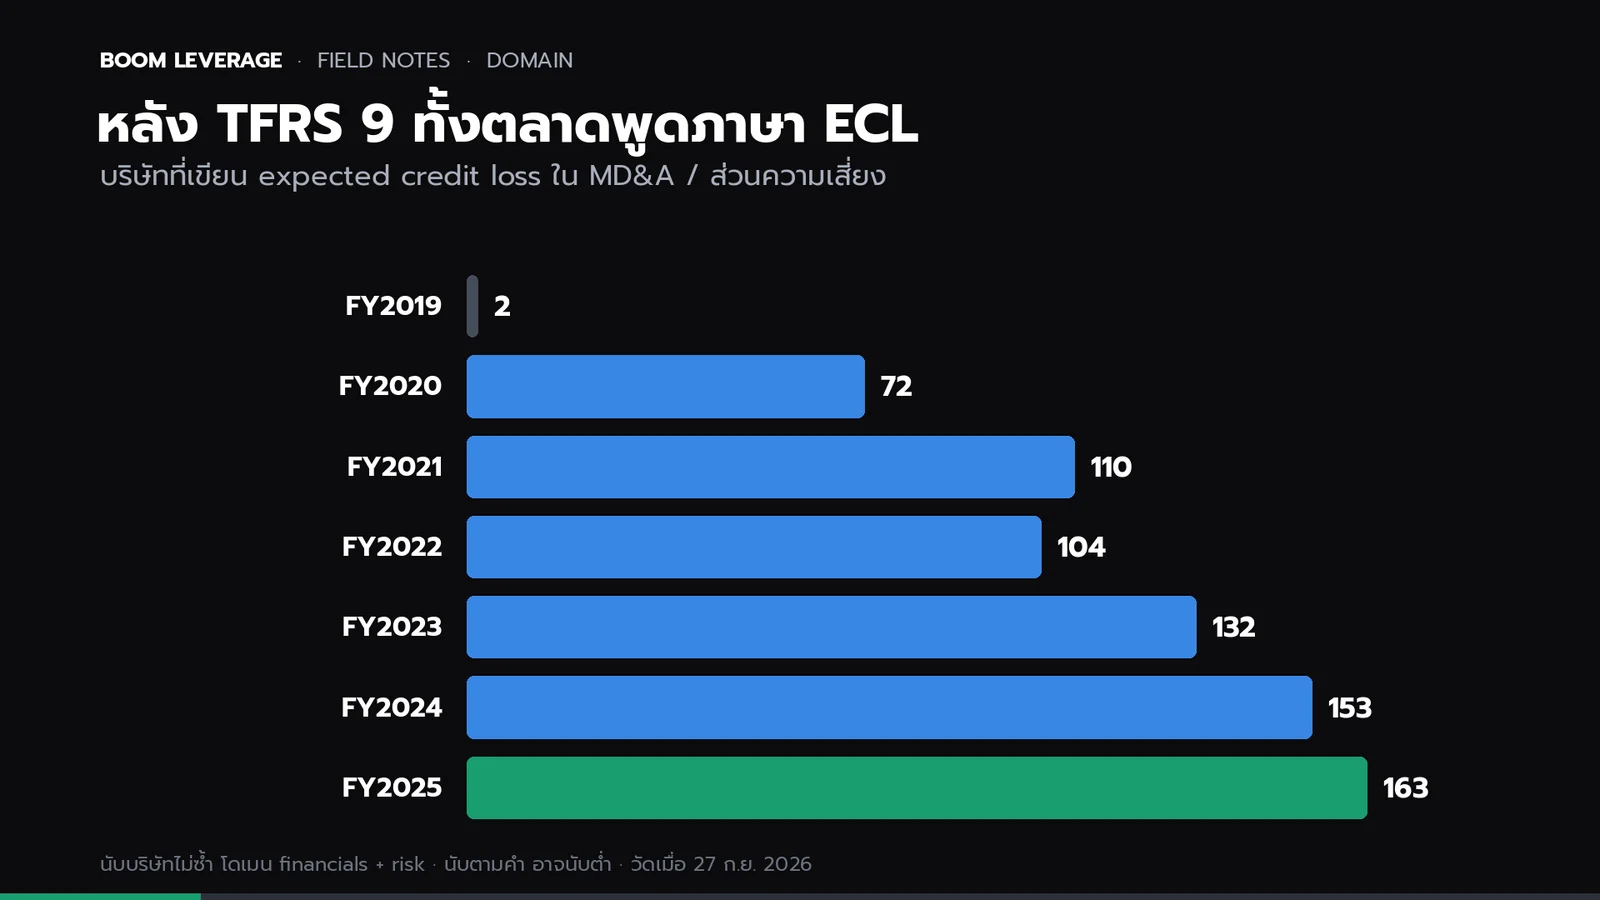
งาน credit risk ไม่ใช่การไล่ accuracy แต่คือวงจร ตั้งคำถาม → สร้าง → พิสูจน์ → เฝ้าดู ที่ต้องตรวจย้อนได้ทุกขั้น บทความนี้เล่าวงจรนั้นจากงาน validation ในแบงก์ และตัวเลขจริงจาก Terminal ว่าหลัง TFRS 9 บริษัทไทยเขียนถึง expected credit loss ใน MD&A เพิ่มจาก 2 เป็น 163 บริษัท
โดย วรัญชัย ยิ่งคำนึง (Boom) · เผยแพร่ครั้งแรก · ตรวจทานล่าสุด

ตอนเริ่มทำงานในสายความเสี่ยงเครดิต ผมเข้าใจผิดอยู่นานว่างานนี้คือการไล่ค่าความแม่นให้สูงที่สุด แต่พอได้ทำงานที่มีคนเอาผลไปตัดสินใจปล่อยสินเชื่อจริง — ทั้งการสร้างระบบ NLP early warning ที่ KBank และการดูแลกระบวนการ ECL รายเดือนพร้อม validate โมเดล TFRS 9 ที่ KTB — ผมพบว่าสิ่งที่ตัดสินว่าโมเดลรอดหรือไม่รอด คือ มันพิสูจน์ตัวเองต่อคนนอกได้หรือเปล่า
วินัยชุดนี้คือสิ่งเดียวกับที่ผมใช้ตอนสร้าง Boom Leverage Terminal บทความนี้จึงเล่าทั้งสองด้าน
ทำไม accuracy ไม่ใช่เป้าหมายของงาน credit risk?
เพราะโมเดลที่แม่นบนกระดาษแต่ใช้ไม่ได้จริง มีค่าน้อยกว่าโมเดลธรรมดาที่ตัดสินใจได้ ปัญหาที่เจอบ่อยเมื่อมองแต่ความแม่น:
| อาการ | ทำไมอันตราย |
|---|---|
| แม่นเพราะใช้ข้อมูลอนาคตที่ตอนใช้งานจริงยังไม่มี (leakage) | คะแนนสวยตอน build แต่พังวันแรกที่ใช้ |
| แม่นกับลูกค้ากลุ่มเก่า พังกับกลุ่มใหม่ | ค่าเฉลี่ยรวมซ่อนปัญหาในกลุ่มย่อย |
| แม่นขึ้นนิดเดียว แต่ซับซ้อนจนอธิบายไม่ได้ | ผ่านด่าน validation และผู้ตรวจไม่ได้ |
วงจรทำงานหน้าตาเป็นยังไง?
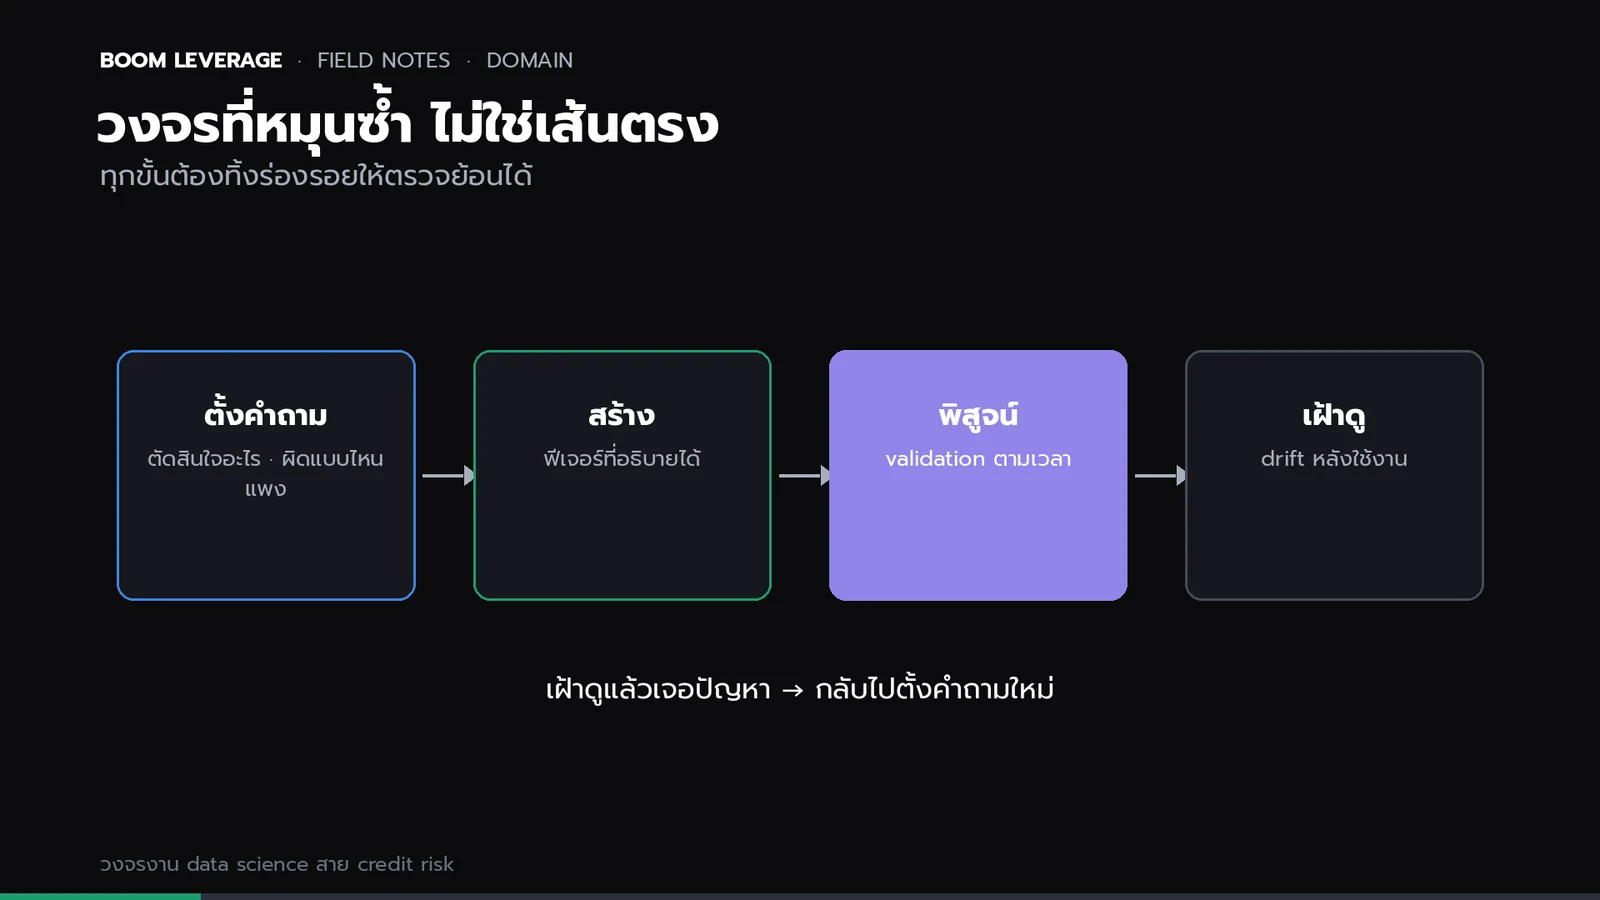
1. ตั้งคำถามธุรกิจก่อนแตะข้อมูล — การตัดสินใจปลายทางคืออะไร (อนุมัติ · วงเงิน · ราคา) · ทำนาย ณ จุดเวลาไหน และตอนนั้นรู้ข้อมูลอะไรจริงๆ · ผิดแบบไหนแพงกว่า (ปล่อยคนที่ควรปฏิเสธ หรือปฏิเสธคนที่ควรปล่อย) สมมติฐานที่ดีต้อง falsifiable — ระบุชัดว่าผลแบบไหนแปลว่าสมมติฐานผิด
2. สร้างฟีเจอร์และโมเดลที่อธิบายได้ — ทุกฟีเจอร์ต้องตอบได้ว่ามาจากไหน คำนวณยังไง และทำไมควรเกี่ยวกับความเสี่ยง ถ้าอธิบายไม่ได้ ไม่ใส่ ต่อให้ช่วยเพิ่มความแม่น และเลือกโมเดลที่เรียบที่สุดเท่าที่งานต้องการก่อน
3. พิสูจน์ด้วย validation ที่เลียนแบบการใช้งานจริง — แบ่งข้อมูลตามเวลา (ทำนายอนาคตจากอดีต) และตรวจเสถียรภาพข้ามกลุ่ม ไม่ใช่ดูค่าเฉลี่ยรวมอย่างเดียว
4. เฝ้าดูหลังใช้งาน — data drift และคุณภาพการทำนายเปลี่ยนตามพฤติกรรมลูกค้าและเศรษฐกิจ ส่งแล้วลืมคือจุดเริ่มของความเสียหาย
TFRS 9 เปลี่ยนภาษาของบริษัทไทยแค่ไหน? (ตัวเลขจริง)
TFRS 9 เปลี่ยนการตั้งสำรองจาก "ขาดทุนที่เกิดแล้ว" เป็น expected credit loss (ECL) — ประมาณการขาดทุนล่วงหน้าจากอดีต ปัจจุบัน และคาดการณ์เศรษฐกิจ มาตรฐานนี้มีผลกับรอบบัญชีที่เริ่มตั้งแต่ 1 ม.ค. 2020 (Forvis Mazars) ผมอยากรู้ว่ามันเปลี่ยนสิ่งที่บริษัทเขียนถึงตัวเองแค่ไหน เลยนับจาก index ของ Terminal:
| ปีงบ | บริษัทที่เขียนถึง ECL | บรรทัดที่พบ | บริษัทที่มีข้อมูลปีนั้น |
|---|---|---|---|
| FY2019 | 2 | 3 | 698 |
| FY2020 | 72 | 336 | 745 |
| FY2021 | 110 | 609 | 812 |
| FY2022 | 104 | 574 | 839 |
| FY2023 | 132 | 685 | 861 |
| FY2024 | 153 | 919 | 864 |
| FY2025 | 163 | 916 | 857 |
ก่อนปี 2020 แทบไม่มีใครเขียน พอมาตรฐานบังคับ ตัวเลขกระโดดทันทีและยังโตต่อ — แนวคิดที่เคยอยู่ในห้อง model risk ของแบงก์ กลายเป็นคำที่บริษัททั่วไปต้องอธิบายให้ผู้ถือหุ้นฟัง
ตัวอย่างบรรทัดจริงที่เป็นกลาง (บริษัทปิดชื่อ) ซึ่งอธิบายว่าการจัดประเภท ECL ใหม่ทำให้ตัวเลขค่าใช้จ่ายเปลี่ยน:

"…mainly due to the reclassification of both actual credit loss and expected credit loss to administrative expenses, effective since the 1st quarter of 2021."
บรรทัดแบบนี้คือเหตุผลที่คนอ่านงบต้องเข้าใจ credit risk: ถ้าเห็นแค่ว่า "ค่าใช้จ่ายบริหารเพิ่ม" โดยไม่อ่านเหตุผล อาจสรุปผิดว่าบริษัทคุมต้นทุนไม่อยู่ ทั้งที่เป็นการย้ายบรรทัดทางบัญชี
ด่านพิสูจน์มีอะไรบ้าง?

- Validation ตามเวลา — เลียนแบบการใช้งานจริง ไม่ใช่สุ่มแบ่งข้อมูลปนอดีตกับอนาคต
- เสถียรภาพข้ามกลุ่ม — ดูผลแยกกลุ่มลูกค้า ไม่ใช่ค่าเฉลี่ยรวม
- เฝ้าดู drift หลังใช้งาน — ตั้งสัญญาณเตือนเมื่อข้อมูลเข้าหรือคุณภาพผลลัพธ์เปลี่ยน
- เอกสารตรวจย้อน — สมมติฐาน เหตุผลของฟีเจอร์ วิธี validation และผลที่ผ่าน ต้องบันทึกให้คนนอกตรวจได้
วินัยนี้กลายเป็น product ได้ยังไง?
ตอนสร้าง Terminal ผมใช้วงจรเดียวกันกับข้อมูลเอกสาร: ตั้งคำถามว่าผู้ใช้ต้องการอะไร (หาข้อความที่บริษัทเขียนเองพร้อมหน้า) · สร้าง index ที่เก็บข้อความต้นฉบับ · พิสูจน์ด้วยการนับว่าชี้ที่มาได้ครบแค่ไหน · และเฝ้าดูความสดของข้อมูลต่อเนื่อง รายละเอียดเรื่องการชี้ที่มาอยู่ใน ทำไม Terminal ต้องชี้เลขหน้าทุกบรรทัด และวิธีอ่านงบแบบคน credit risk อยู่ใน อ่านงบการเงิน 3 มุม
เครื่องมือ AI อย่าง Claude Code ช่วยเร่งทุกขั้นของวงจรได้ — ร่างสมมติฐาน เขียนโค้ดฟีเจอร์ ตั้ง validation จัดเอกสาร — แต่เร่งได้ก็ต่อเมื่อเราวางด่านตรวจไว้ก่อน (ทำไม harness สำคัญกว่าโมเดล)